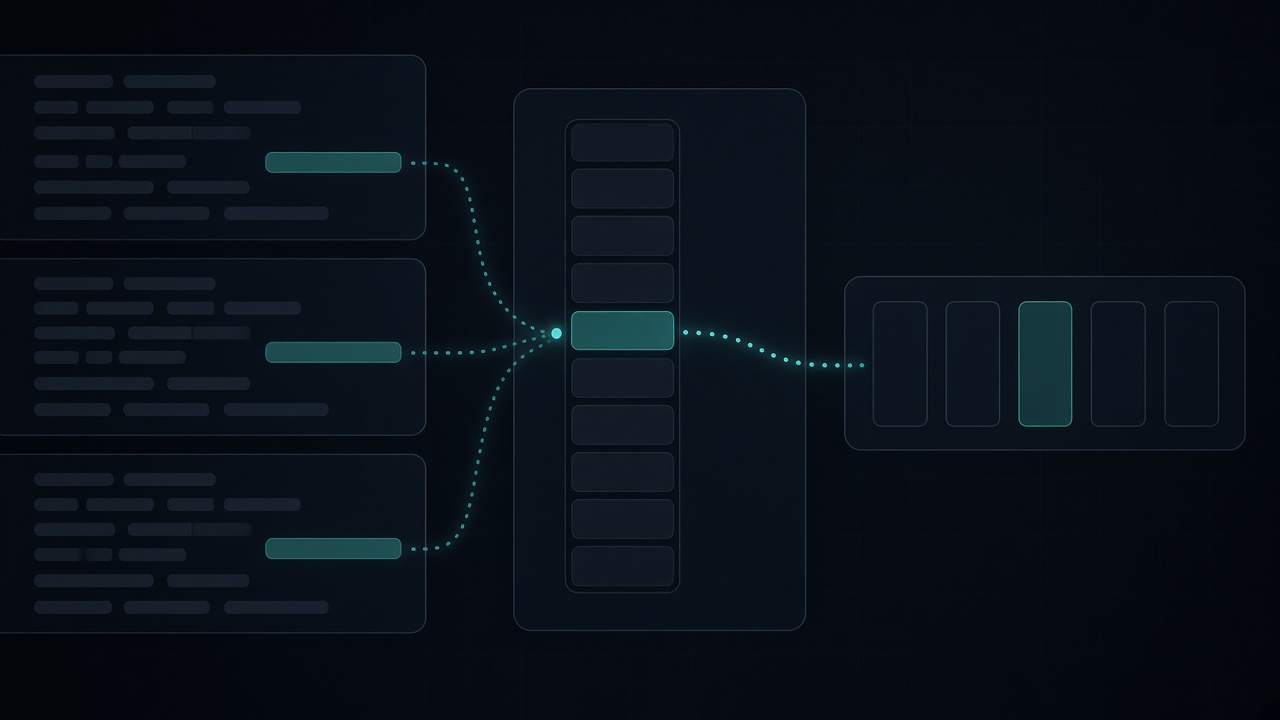
Correlation ID: um código por requisição que liga a tela de erro ao log
Gere um identificador na entrada de cada requisição, carregue esse id em todo log, fila e chamada seguinte e mostre-o na tela de falha para o suporte achar a história inteira com uma busca.
O e-mail do cliente diz: "tentei fechar o pedido ontem por volta das 15h e deu erro". Vem um print da tela genérica. Você abre o log daquele minuto e encontra 1.300 linhas de três servidores e dois workers. Nenhuma diz que era ele. O chamado termina em "não conseguimos reproduzir".
A resposta curta: gere um identificador único na entrada de cada requisição, coloque esse id em toda linha de log, repasse para a fila e para as chamadas a outros serviços, devolva no cabeçalho da resposta e mostre na tela de erro como "código do atendimento". Com esse código no print, uma busca no log traz a história inteira daquela requisição, do clique ao worker que falhou.
Por que o horário e o e-mail não bastam
Horário aproximado é uma janela, não um endereço. Num sistema com algumas dezenas de requisições por segundo, um minuto tem milhares de linhas, e as linhas de requisições diferentes se intercalam. Mesmo achando a linha do erro, você não sabe quais linhas anteriores pertenciam ao mesmo pedido.
Usar o e-mail ou o CPF como chave de busca parece prático, mas tem dois problemas. Primeiro, coloca dado pessoal em todo log, o que o post sobre log sem senha recomenda evitar. Segundo, a mesma pessoa faz várias requisições, inclusive em abas diferentes, e o e-mail não separa uma tentativa da outra.
O identificador por requisição resolve os dois: é aleatório, não diz nada sobre ninguém e marca exatamente um caminho pelo sistema.
Como o id atravessa o sistema
O exemplo é o checkout de uma loja com Node.js, Express e o logger pino, atrás de um nginx, com um worker que processa a emissão da nota a partir de uma fila. O mesmo id precisa aparecer nos quatro pontos.
- Gere na borda. Se há proxy reverso, ele pode criar o id; se não, a aplicação cria. O id que vem da internet só deve ser aceito se tiver formato válido.
- Guarde num contexto da requisição, para que qualquer função consiga ler sem receber o id por parâmetro.
- Inclua em toda linha de log automaticamente, pelo logger, e não lembrando de escrever em cada chamada.
- Repasse adiante: no cabeçalho das chamadas HTTP a outros serviços e nos metadados das mensagens de fila.
- Devolva para o cliente no cabeçalho
X-Request-Ide no corpo da página ou JSON de erro.
No nginx
O nginx tem a variável $request_id, um valor aleatório em hexadecimal por requisição. Repasse para a aplicação e grave no log de acesso:
log_format comid '$remote_addr [$time_local] "$request" $status $request_id';

server {
    listen 443 ssl;
    server_name loja.exemplo;
    access_log /var/log/nginx/loja.log comid;

    location / {
        proxy_set_header X-Request-Id $request_id;
        proxy_pass http://127.0.0.1:3000;
    }
}
Como o proxy_set_header sobrescreve o cabeçalho, um valor forjado pelo cliente não chega à aplicação.
Na aplicação Node.js
O AsyncLocalStorage, do módulo async_hooks, guarda um valor que acompanha a requisição através de await e callbacks. O pino tem a opção mixin, uma função cujo retorno é mesclado em cada linha de log:
const { AsyncLocalStorage } = require('async_hooks');
const crypto = require('crypto');
const express = require('express');
const pino = require('pino');

const contexto = new AsyncLocalStorage();
const logger = pino({
  mixin() {
    const ctx = contexto.getStore();
    return ctx ? { requestId: ctx.requestId } : {};
  }
});

const FORMATO = /^[A-Za-z0-9-]{16,64}$/;

function idDaRequisicao(req, res, next) {
  const recebido = req.get('X-Request-Id');
  const requestId = recebido && FORMATO.test(recebido) ? recebido : crypto.randomUUID();
  res.set('X-Request-Id', requestId);
  contexto.run({ requestId }, () => next());
}

const app = express();
app.use(idDaRequisicao);
app.use(express.json());

app.post('/checkout', async (req, res, next) => {
  try {
    logger.info({ itens: req.body.itens.length }, 'checkout iniciado');
    const pedido = await criarPedido(req.body);
    await fila.publicar('emitir-nota', { pedidoId: pedido.id }, {
      headers: { 'x-request-id': contexto.getStore().requestId }
    });
    res.status(201).json({ pedidoId: pedido.id });
  } catch (err) {
    next(err);
  }
});
A validação com FORMATO importa: um cabeçalho com quebras de linha ou texto gigante, gravado sem filtro, polui o log e pode forjar linhas falsas. Valor fora do padrão é descartado e substituído por um novo.
No worker, a primeira coisa ao receber a mensagem é abrir o mesmo contexto com o id que veio nos cabeçalhos, chamando contexto.run({ requestId: mensagem.headers['x-request-id'] }, ...). A partir daí, o log do worker carrega o mesmo campo do log da API. A forma exata de ler cabeçalhos de mensagem depende da biblioteca de fila que você usa; o princípio é o mesmo em todas.
Na tela de erro
O tratador de erro registra a exceção completa no log e mostra para a pessoa só uma frase e o código: "Não conseguimos concluir seu pedido. Se precisar de ajuda, informe o código 3f9c1a2e-7b41-4c0e-9d55-0a8e6b2f1c47". O post a pilha não vai para a tela detalha esse tratador; aqui o que importa é que o código exibido seja o mesmo id dos logs.
Buscando a história inteira
Com o código do print, a busca vira uma linha, seja no Loki, no Elasticsearch, no CloudWatch ou num arquivo:
$ grep '3f9c1a2e-7b41-4c0e-9d55-0a8e6b2f1c47' /var/log/loja/*.log
api.log:   {"level":30,"requestId":"3f9c1a2e-...","itens":3,"msg":"checkout iniciado"}
api.log:   {"level":30,"requestId":"3f9c1a2e-...","pedidoId":8812,"msg":"pedido criado"}
worker.log:{"level":50,"requestId":"3f9c1a2e-...","pedidoId":8812,"msg":"falha ao emitir nota: timeout"}
Três linhas em dois processos contam o caso: o pedido foi criado e a falha foi na emissão da nota, no worker. Sem o id, a linha do worker estaria perdida entre centenas de outras emissões.
E o padrão W3C Trace Context
A especificação Trace Context, do W3C, define o cabeçalho traceparent, que carrega um trace-id de 32 caracteres hexadecimais entre serviços. Ferramentas de rastreamento distribuído, como o OpenTelemetry, geram e propagam esse cabeçalho automaticamente na maioria das bibliotecas HTTP instrumentadas.
Se você já usa OpenTelemetry, não invente um segundo id: use o trace-id como código de atendimento e garanta que ele aparece no log. Se ainda não usa, o X-Request-Id feito à mão já resolve a maior parte do problema e pode ser substituído depois sem mudar a ideia.
Erros comuns
- Gerar um id novo em cada serviço: cada pedaço da história tem um código diferente e a busca encontra só o primeiro trecho.
- Esquecer a fila: o log da API e o do worker não se ligam, e justamente a parte assíncrona, onde a falha costuma estar, fica órfã.
- Aceitar qualquer
X-Request-Idvindo do cliente: alguém injeta texto arbitrário no seu log ou reutiliza o id de outra pessoa para confundir a investigação. - Passar o id por parâmetro em cada função: metade das funções esquece, e as linhas sem id são exatamente as que você precisava.
- Usar e-mail ou CPF como id: dado pessoal espalhado em todo log, sem separar uma tentativa da outra.
- Mostrar a pilha junto com o código: o código já basta para o suporte; a pilha só ensina o caminho interno a quem não devia ver.
Checklist
- Toda resposta da aplicação tem o cabeçalho
X-Request-Id. - Toda linha de log da API tem o campo
requestId, sem precisar escrever à mão. - Mensagens de fila carregam o id e o worker abre o contexto com ele.
- Chamadas HTTP a outros serviços repassam o id no cabeçalho.
- Ids recebidos de fora são validados por formato e tamanho.
- A tela de erro mostra o código, e o suporte sabe pedir esse código.
- Uma busca pelo código no log traz linhas de todos os processos envolvidos.
Pegue o último erro que um cliente relatou: com as informações que ele mandou, dá para achar no log a falha exata que ele viu, com um código só?
Referência: https://www.w3.org/TR/trace-context/