CVE-2026-97631: falha no PXE do UEFI e como se proteger
Falha no PXE do EDK II (CVE-2026-97631) roda código antes do Secure Boot. Veja como checar servidores e VMs, desligar o PXE e quem já tem correção.
A CVE-2026-97631 é um estouro de buffer no driver de boot por rede (PXE) do TianoCore EDK II, o código aberto que está por baixo da maior parte dos firmwares UEFI de servidores, de placas-mãe e das VMs QEMU/KVM (o OVMF). Durante um boot PXE, uma mensagem ICMP de erro maior que 504 bytes passa do espaço reservado na memória. No pior caso, quem conhece a versão exata do firmware consegue rodar código no ring 0 antes de o sistema operacional subir e antes de o Secure Boot conferir qualquer coisa.
O advisory oficial do TianoCore (GHSA-99cj-7hg9-mp4m) classifica a falha como crítica, com nota 9,5 no CVSS 4.0. Não há exploração conhecida, e a falha só existe enquanto a máquina está dando boot pela rede: quem liga o servidor só pelo disco não fica exposto. O problema é que a correção, na prática, depende de cada fabricante soltar uma atualização de BIOS/UEFI, e até a madrugada de 29/10 quase nenhum tinha feito isso. A seguir: o que aconteceu, como a falha funciona, como descobrir se os seus servidores e VMs usam PXE com EDK II, quem já publicou correção e o que fazer enquanto o update não chega.
Linha do tempo: uma correção que vazou antes da hora
- 28/09/2026: data do commit com a correção no driver
NetworkPkg/UefiPxeBcDxe, assinado por um engenheiro da AMI, uma das maiores fornecedoras de BIOS do mundo. - 14/10: o pull request #13302, com o título já citando a CVE, é aberto no repositório público do EDK II. Na mesma noite (21h09 em Brasília) a correção entra no branch master, junto com testes de unidade e um commit extra que zera o buffer antes de cada cópia.
- 22/10: o TianoCore publica o advisory. A NVD registra a CVE no mesmo dia.
- 26/10: o Project Mu, fork do EDK II mantido pela Microsoft, publica versões com a correção, e o Fedora começa a distribuir pacotes
edk2corrigidos. - 27/10: a Ars Technica conta que a divulgação coordenada estava marcada para janeiro e foi atropelada pela publicação da correção pela AMI. Segundo a reportagem, o código vulnerável tem cerca de 16 anos.
- 28/10: o caso chega à lista oss-security, e a Hetzner abre um aviso na sua página de status.
A falha foi encontrada por Alex Matrosov (Anthropic) e Dan Holmes-Mitra (Google), creditados no advisory. Com o patch público desde 14/10, qualquer pessoa consegue ver exatamente qual trecho foi corrigido. Por isso a janela entre "correção existe" e "correção instalada" é o que importa aqui.
Como a falha funciona
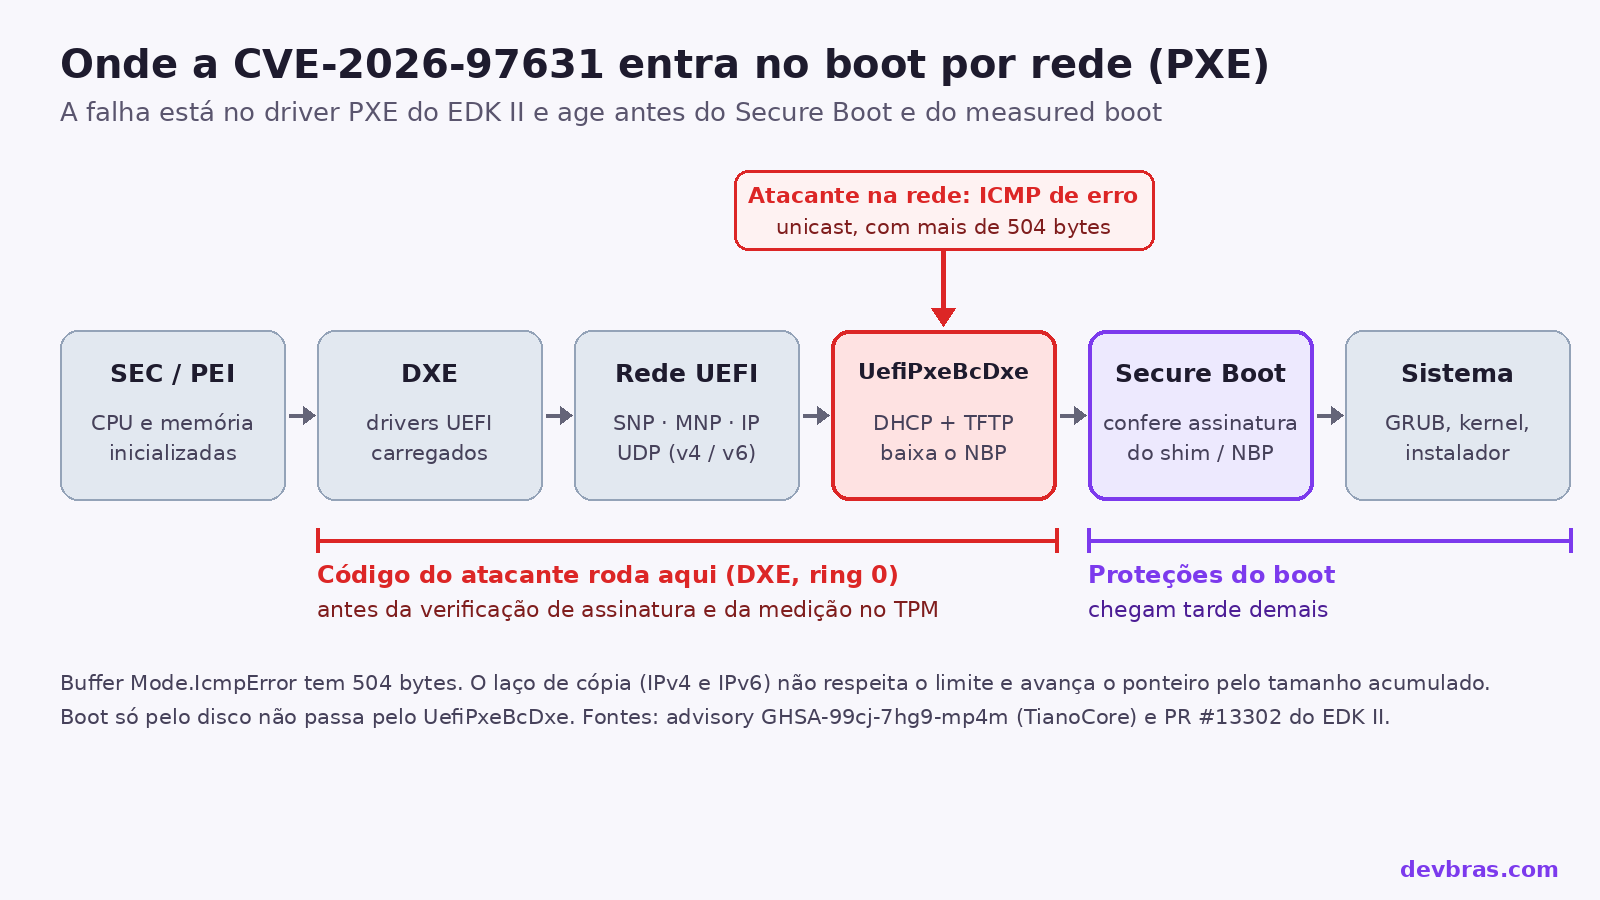
No boot PXE, o firmware pede um endereço por DHCP, baixa um programa de boot (o NBP, normalmente via TFTP) e passa o controle para ele. Enquanto isso acontece, o driver PXE Base Code deixa uma escuta aberta para mensagens ICMP de erro, como "destino inalcançável", e copia cada uma para um campo fixo de 504 bytes chamado Mode.IcmpError.
Segundo o advisory, o laço de cópia erra o limite nos dois tratadores, o de IPv4 (PxeBcIcmpErrorDpcHandle) e o de IPv6 (PxeBcIcmp6ErrorDpcHandle). Quando a mensagem passa de 504 bytes, ele continua copiando, e ainda avança o ponteiro de destino pelo tamanho acumulado em vez do tamanho de cada fragmento. Nada antes disso limita o tamanho da mensagem. Os bytes enviados pelo atacante caem por cima da memória vizinha, na fase DXE do firmware, quando os drivers UEFI estão carregados e nenhum controle do sistema operacional existe ainda.
O desenho abaixo mostra onde a falha entra no caminho do boot.
O advisory descreve dois resultados possíveis:
- Travamento do boot: a corrupção dos dados do driver é determinística e, no ICMP de erro seguinte, gera uma exceção na CPU. A máquina não termina o boot, o que derruba provisionamento e recuperação feitos por rede.
- Execução de código: quem conhece o build exato do firmware pode plantar no mesmo pacote um evento falso que o firmware executa na fase DXE, no ring 0. Isso acontece antes de o Secure Boot verificar o carregador do sistema e antes de o measured boot registrar qualquer coisa no TPM.
Para o ataque, basta um ICMP de erro unicast endereçado ao IP do cliente PXE, "de qualquer distância na rede", diz o advisory, desde que chegue durante o boot. Não precisa de senha nem de interação.
O que a falha exige e o que ela não faz
A nota 9,5 assusta, mas a falha tem limites claros, e eles ajudam a priorizar:
- Só existe durante o boot por rede. Servidor que já está no ar não é atacável por ela. A Hetzner escreveu isso com todas as letras no aviso dela.
- Precisa alcançar a máquina naquele intervalo de segundos. Na prática, isso favorece quem já está dentro da rede, como um insider ou um invasor que já entrou e quer subir de nível. A Ars não encontrou nada indicando que a falha sirva como porta de entrada.
- A execução de código precisa ser ajustada para cada alvo. Jesse Michael, da Eclypsium, disse à Ars que o atacante precisa adivinhar endereços específicos, que mudam conforme modelo, versão e configuração. Sem isso, o resultado é o travamento.
- O código injetado não persiste sozinho. Ele roda uma vez, mas nesse momento tem acesso ao que o firmware tem, inclusive ao TPM. HD Moore, também ouvido pela Ars, lembrou que isso pode servir para quebrar criptografia de disco amarrada ao TPM.
- A correção é simples de aplicar. Diferente de BlackLotus e BootHole, não envolve revogar chaves nem mexer na dbx do Secure Boot. Basta atualizar o firmware.
Por que as notas não batem: 9,5, 8,8 e "Medium"
Cada organização está pesando o risco de um jeito. O TianoCore usa o vetor de rede (AV:N) no CVSS 4.0 e chega a 9,5. A Red Hat chama a falha de crítica, mas o rascunho de CVSS 3.1 dela usa vetor adjacente (AV:A) e dá 8,8. A SUSE classifica como importante. O Ubuntu classificou com prioridade média, e o Debian anotou o trixie como no-dsa (Minor issue), ou seja, sem aviso de segurança dedicado. A NVD deixou a análise como "Deferred" e repete só a nota do TianoCore.
A leitura das distribuições faz sentido para o pacote delas: o OVMF de uma VM só faz PXE se alguém configurou isso, e o boot acontece numa rede virtual. Para quem mantém frota física com provisionamento por PXE, como bare metal, clusters e laboratórios, o peso é outro. Ali o boot por rede acontece toda vez que uma máquina é reinstalada ou reiniciada, e a rede de provisionamento costuma ser a menos vigiada da empresa.
Seu servidor ou VM usa EDK II com PXE?
São duas perguntas: se o firmware é baseado em EDK II e se o boot por rede está ligado. A primeira raramente tem resposta direta, porque AMI, Insyde, Phoenix e o Project Mu usam muito código do EDK II, e o fabricante quase nunca diz quais módulos entraram. A segunda dá para responder em minutos.
Máquina física ou VM com Linux
Primeiro, veja se a máquina deu boot em modo UEFI. Se a pasta não existir, ela está em BIOS legado, e esta CVE, que é do driver PXE do UEFI, não se aplica a esse boot.
[ -d /sys/firmware/efi ] && echo "UEFI" || echo "BIOS legado"
Depois, anote fabricante e versão do firmware. É com esses dados que você vai procurar o boletim certo no site do fabricante.
sudo dmidecode -s bios-vendor
sudo dmidecode -s bios-version
sudo dmidecode -s bios-release-date
sudo dmidecode -s system-product-name
Por último, liste as entradas de boot e procure as de rede. Entradas PXE aparecem com nomes como "UEFI PXEv4" ou "PXE IPv4" e com um caminho de dispositivo que contém MAC( e IPv4( ou IPv6(. A linha BootOrder mostra em que posição elas estão.
sudo efibootmgr -v
sudo efibootmgr -v | grep -iE 'pxe|mac\('
Se aparecer entrada PXE na frente do disco, a máquina pode dar boot pela rede sem ninguém pedir. Se ela estiver depois do disco, ainda pode ser usada como plano B quando o disco falhar.
Atualização de firmware pelo fwupd
Em servidores e desktops cujo fabricante publica firmware no LVFS, o fwupd mostra a versão instalada e se existe atualização. Vale rodar, mas não conte com ele para tudo: muitos servidores só recebem BIOS pelo portal do fabricante ou pela controladora de gerenciamento (iDRAC, iLO, XClarity, BMC).
fwupdmgr get-devices
fwupdmgr refresh
fwupdmgr get-updates
VMs QEMU/KVM e libvirt (OVMF)
No host, veja qual firmware cada VM usa. Se a linha loader apontar para um arquivo OVMF (ou AAVMF, no ARM), a VM roda EDK II.
virsh dumpxml NOME_DA_VM | grep -iE 'loader|nvram|boot '
E confira a versão do pacote do firmware no host:
# Debian e Ubuntu
dpkg -l ovmf
apt-cache policy ovmf

# Fedora, RHEL e derivados
rpm -q edk2-ovmf
Testamos isso em 29/10 em containers Docker com as imagens oficiais. No debian:trixie, o candidato é ovmf 2025.02-8+deb13u1, que o tracker do Debian marca como vulnerável. No ubuntu:24.04, ovmf 2024.02-2ubuntu0.10, ainda em avaliação no tracker do Ubuntu. No fedora:43, o repositório estável entrega edk2-ovmf 20260812-4.fc43, e a versão corrigida, 20260812-6.fc43, está só no updates-testing.
Também subimos o OVMF do Debian trixie no QEMU, com placa de rede virtio e um gerador de números aleatórios virtual, sem disco que desse boot. O firmware criou sozinho as entradas "UEFI PXEv4" e "UEFI PXEv6" e tentou o boot por rede (Start PXE over IPv4) antes de cair no shell. Ninguém configurou PXE. Bastou não ter um disco de boot válido. Sem o gerador de números aleatórios, a pilha de rede desse OVMF nem sobe: a partir de 2025 o Debian passou a exigir uma fonte de aleatoriedade para o boot por rede, como avisa o changelog do pacote.
Containers Docker
Um container não tem firmware próprio. Rodando efibootmgr -v dentro de um container Debian, a resposta foi EFI variables are not supported on this system., e o dmidecode sem privilégio não consegue ler /dev/mem. O que importa é o firmware do host, físico ou VM, onde o Docker roda. A exceção é quando o container é ele mesmo um hipervisor, como imagens que rodam QEMU ou o virt-launcher do KubeVirt. Aí o OVMF vem dentro da imagem, e quem corrige é a atualização da imagem.
VMs na nuvem
Em AWS, Azure, Google Cloud e similares, o firmware da VM é do provedor. Não há o que atualizar de dentro da instância, e o normal é que ela dê boot por disco. O que resta é acompanhar os boletins do provedor e, em bare metal alugado, perguntar como o provisionamento por rede é protegido.
Quem já publicou correção (até 29/10, 0h de Brasília)
A lista abaixo traz só o que encontramos nas páginas oficiais. "Sem boletim" quer dizer que não achamos nada publicado, e não que o produto está seguro.
Com correção disponível
- TianoCore EDK II: corrigido no branch master desde 14/10 (commit fa78907). Nenhuma versão estável tem a correção ainda: a última,
edk2-stable202608, está na faixa afetada, e o campo de versão corrigida do advisory ainda diz "Not patched currently". - Project Mu (Microsoft): backport nas versões v2026080000.0.5 (26/10) e v2025110002.0.20 (28/10) do mu_basecore. Isso é código-fonte para quem monta firmware, não um update para instalar.
- Fedora:
edk2-20260812-12.fc46ou mais novo já é estável no Rawhide. Para o Fedora 43 (20260812-6.fc43), o 44 (20260812-10.fc44) e o 45 (20260812-10.fc45), os pacotes corrigidos estão emupdates-testingno Bodhi.
Afetados, sem correção publicada
- Red Hat:
edk2afetado no RHEL 8, 9 e 10 e no RHCOS do OpenShift 4, sem errata. - Debian: bookworm, trixie e forky/sid vulneráveis, sem versão corrigida (bug 1151853).
- Ubuntu:
edk2como "Needs evaluation" do 18.04 ao 26.10. - SUSE e openSUSE:
ovmfafetado, com estado "Pending". - Hetzner: aviso em investigação desde 28/10. A empresa diz que não há patch oficial e recomenda evitar reiniciar os servidores que dão boot por PXE até segunda ordem.
Sem boletim encontrado
- AMI: nada na central de segurança (ami.com/security-center), embora a correção tenha saído de um engenheiro dela.
- Supermicro: nada na central de segurança (supermicro.com/en/support/security_center). Os itens mais recentes são de BMC, de 26/10.
- Dell, HPE e Lenovo: nenhum boletim localizado nos portais e nas buscas.
- AWS, Google Cloud e Microsoft/Azure: nada nas páginas de boletins da AWS e do Google Cloud, e nenhuma entrada no guia de atualizações da Microsoft (MSRC).
- Intel e Arm: responderam à Ars, mas não publicaram boletim. A Intel diz que nenhum produto comercial dela sob suporte é afetado conhecidamente, mas que um fabricante de placa pode ter incluído o código. A Arm diz que a falha "não se aplica diretamente" aos produtos dela.
O que fazer enquanto o update de BIOS não sai
- Desligue o boot por rede onde ele não é usado. É a mitigação recomendada pela Ars e pelos pesquisadores. Em servidor físico, isso se faz no setup do firmware ou pela controladora de gerenciamento, tirando o PXE da ordem de boot e, se houver a opção, desligando a pilha de rede do UEFI.
- Em VMs QEMU, desligue o PXE do OVMF. O OVMF lê duas chaves de configuração no boot. Testamos com o OVMF do Debian trixie: com elas, as entradas PXEv4 e PXEv6 deixaram de existir.
qemu-system-x86_64 ... \
  -fw_cfg name=opt/org.tianocore/IPv4PXESupport,string=n \
  -fw_cfg name=opt/org.tianocore/IPv6PXESupport,string=n
No libvirt, o mesmo vai num bloco <sysinfo type='fwcfg'> do XML da VM, com uma <entry name='opt/org.tianocore/IPv4PXESupport'>n</entry> para cada chave. Esse caminho segue a documentação do libvirt e não foi testado por nós. Repare que isso não desliga o boot por HTTP (UEFI HTTPv4/HTTPv6), que usa outro driver e não é o afetado por esta CVE.
- Isole a rede de provisionamento. Como o ataque só precisa de um ICMP de erro chegando ao cliente durante o boot, uma VLAN de PXE separada, sem rota de fora, com filtro para ICMP de erro vindo de origens que não sejam o servidor de boot e o gateway, reduz muito a superfície.
- Planeje os reboots. Em frota que só dá boot por PXE e não pode desligar o recurso, siga a linha da Hetzner: reinicie só o necessário e de preferência numa rede controlada.
- Mantenha Secure Boot e TPM ligados, sabendo que eles não barram esta falha específica, porque o código roda antes da verificação.
- Atualize assim que o fabricante publicar. Como a correção é só no firmware, não precisa trocar chave nem mídia de instalação. Em VMs, depois de atualizar o pacote
ovmfouedk2-ovmfno host, desligue e ligue a VM de novo (stop/start, não reboot de dentro do sistema). O QEMU carrega o arquivo do firmware quando o processo sobe.
Atualização de firmware é das poucas que podem deixar uma máquina sem boot. Tenha acesso de console fora de banda e saiba como recuperar o sistema se algo der errado. O nosso guia de kernel panic "Unable to mount root fs" ajuda se o problema aparecer depois, já no Linux. E se você também cuida de servidores Linux expostos, a atualização de kernel desta semana é bem mais urgente que esta: veja a falha do kernel que a CISA confirmou como explorada.
Por que isso vai durar
Corrigir o EDK II no GitHub foi a parte fácil. Agora a correção precisa entrar nos códigos dos fornecedores de BIOS, depois nos firmwares de cada fabricante, modelo por modelo, e só então ser instalada máquina por máquina. HD Moore disse à Ars que deve virar um bug "eterno", que vai continuar vivo em equipamentos sem suporte. Não é a primeira vez: em 2024 o PixieFail já tinha mostrado falhas parecidas na mesma pilha de rede do EDK II. E é a segunda divulgação atropelada em poucos dias, depois do PHP2Shell. Para quem mantém servidores, o trabalho útil agora é inventário: saber quais máquinas dão boot pela rede, de qual fabricante e com qual versão de firmware, para aplicar a atualização assim que cada boletim sair.
Em resumo
- O quê: CVE-2026-97631, estouro de buffer no driver PXE do EDK II (
NetworkPkg/UefiPxeBcDxe). Um ICMP de erro com mais de 504 bytes, durante o boot por rede, pode travar o boot ou executar código antes do Secure Boot. - Quem está exposto: máquinas com firmware UEFI baseado em EDK II que dão boot por PXE, sobre IPv4 ou IPv6. Boot só por disco não é afetado. Sem exploração conhecida.
- Correção: no master do EDK II, no Project Mu e no Fedora. Para servidores físicos, depende do update de BIOS/UEFI de cada fabricante, e quase nenhum saiu até 29/10.
- Agora: rode
efibootmgr -vedmidecode, desligue o PXE onde não usa, isole a rede de provisionamento e acompanhe os boletins do seu fabricante.
Fontes oficiais: advisory GHSA-99cj-7hg9-mp4m do TianoCore, pull request #13302 do EDK II, NVD, Red Hat, Debian, Ubuntu, SUSE, Fedora Bodhi, Project Mu, Hetzner e oss-security. Reportagem citada: Ars Technica, 27/10/2026 ("Code execution flaw in UEFI firmware threatens most servers on planet Earth").
Equipe DevBras