Alerta no Prometheus por SLO, testado com promtool
Alertas no Prometheus por orçamento de erro, testados com promtool contra pico, queda e erro parcial, e roteamento do Alertmanager conferido com amtool.
Um alerta que dispara toda semana sem pedir nada treina quem está de plantão a ignorar o próximo. A solução conhecida é alertar por sintoma, com limiar e duração, e mandar para o celular só o que exige ação imediata. O difícil é provar, antes de colocar em produção, que a regra nova não acorda ninguém por um pico de um minuto e ainda assim avisa a tempo quando o checkout cai. Este guia monta alertas por orçamento de erro no Prometheus 3.15.1, testa as regras com o promtool contra cenários simulados e confere o roteamento do Alertmanager 0.34.1 com o amtool, tudo sem servidor no ar.
Página, chamado ou painel
O capítulo de monitoramento de sistemas distribuídos do livro de SRE do Google resume o critério: uma página deve ser urgente, acionável e exigir uma pessoa pensando. Na prática, três destinos:
- Página (acorda alguém): clientes afetados agora, e existe um primeiro passo que uma pessoa precisa dar.
- Chamado (horário comercial): precisa de ação, mas pode esperar, como um certificado que vence em três semanas ou um disco que enche em quatro dias.
- Painel (ninguém é notificado): CPU, memória e latência por réplica, para investigar.
Se você não consegue escrever a primeira ação de quem recebe o alerta, ele não é página. Se a ação é sempre o mesmo comando, ela é automação, e o alerta deve disparar só quando a automação falhar.
Antes de escrever regra nova, conte as antigas
O Prometheus grava, para cada alerta pendente ou disparando, a série ALERTS_FOR_STATE, cujo valor é o instante em que o alerta ficou ativo. Cada novo disparo muda esse valor, então changes() conta quantas vezes a regra voltou a disparar no período (some 1 para incluir o primeiro). Num teste com dois picos, a consulta devolveu 1. A lista das regras mais barulhentas é por onde a limpeza começa:
# regras que mais voltaram a disparar nos últimos 30 dias
topk(15, sum by (alertname, severity) (
  changes(ALERTS_FOR_STATE[30d])
))
Para cada uma das primeiras, anote o que foi feito nas últimas vezes: nada, reiniciar, abrir chamado ou corrigir. Regra que só tem "nada" sai ou vira painel. Regra de causa (CPU, memória) dá lugar a uma regra de sintoma, que é o que vem a seguir.
Alerta por orçamento de erro
Em vez de "erro acima de 5%", a regra parte de um objetivo: 99,5% das requisições do checkout sem erro 5xx em 30 dias. Sobra 0,5% de orçamento de erro, e o alerta mede a velocidade com que ele está sendo gasto. O capítulo sobre alertas por SLO do workbook de SRE recomenda como ponto de partida página quando 2% do orçamento some em uma hora (14,4 vezes o ritmo permitido) e chamado quando 10% some em três dias, sempre conferindo uma janela longa e uma curta ao mesmo tempo. A janela longa evita disparo por pico; a curta faz o alerta parar logo que o problema acaba.
# SLO: 99,5% das requisições do checkout sem erro 5xx em 30 dias (orçamento de erro: 0,5%)
groups:
  - name: checkout-slo-gravacao
    rules:
      - record: checkout:erro_5xx:razao_5m
        expr: |
          sum(rate(http_requests_total{job="loja-api", rota="/checkout", status=~"5.."}[5m]))
          /
          sum(rate(http_requests_total{job="loja-api", rota="/checkout"}[5m]))
      - record: checkout:erro_5xx:razao_1h
        expr: |
          sum(rate(http_requests_total{job="loja-api", rota="/checkout", status=~"5.."}[1h]))
          /
          sum(rate(http_requests_total{job="loja-api", rota="/checkout"}[1h]))
      - record: checkout:erro_5xx:razao_6h
        expr: |
          sum(rate(http_requests_total{job="loja-api", rota="/checkout", status=~"5.."}[6h]))
          /
          sum(rate(http_requests_total{job="loja-api", rota="/checkout"}[6h]))
      - record: checkout:erro_5xx:razao_3d
        expr: |
          sum(rate(http_requests_total{job="loja-api", rota="/checkout", status=~"5.."}[3d]))
          /
          sum(rate(http_requests_total{job="loja-api", rota="/checkout"}[3d]))

  - name: checkout-slo-alertas
    rules:
      - alert: CheckoutQueimandoOrcamentoRapido
        # 14,4x o ritmo permitido: 2% do orçamento do mês some em 1 hora
        expr: |
          checkout:erro_5xx:razao_1h > (14.4 * 0.005)
          and
          checkout:erro_5xx:razao_5m > (14.4 * 0.005)
        for: 2m
        labels:
          severity: page
        annotations:
          summary: "Checkout com {{ $value | humanizePercentage }} de erro 5xx na última hora"
          description: "Clientes não conseguem pagar. Primeiro passo: ver se houve deploy nos últimos 60 min e o status do gateway."
          runbook_url: "https://github.com/SUA-ORGANIZACAO/runbooks/blob/main/checkout-5xx.md"

      - alert: CheckoutQueimandoOrcamentoDevagar
        # 1x o ritmo: 10% do orçamento em 3 dias; pede ação, não precisa acordar ninguém
        expr: |
          checkout:erro_5xx:razao_3d > 0.005
          and
          checkout:erro_5xx:razao_6h > 0.005
        for: 1h
        labels:
          severity: ticket
        annotations:
          summary: "Checkout gastando o orçamento de erro mais rápido que o previsto há 3 dias"
          runbook_url: "https://github.com/SUA-ORGANIZACAO/runbooks/blob/main/checkout-5xx.md"
Os nomes http_requests_total, rota e status dependem de como a sua aplicação exporta métricas; ajuste. O runbook_url deve apontar para a página real com o primeiro comando. As regras de gravação (record) calculam as razões uma vez por ciclo, em vez de repetir a conta em cada alerta. O workbook também sugere uma segunda regra de página, de 5% do orçamento em seis horas (6 vezes o ritmo, com janela curta de 30 minutos), para quedas parciais que duram a tarde toda.
Teste a regra antes de ela te acordar
O promtool tem testes de unidade para regras: você descreve as séries minuto a minuto e diz quais alertas devem estar disparando em cada instante. Três cenários cobrem o que importa: dia normal, pico curto e queda de verdade.
rule_files:
  - regras.yml
evaluation_interval: 1m

tests:
  # 1000 pedidos/min no checkout; 0,2% de erro é o normal desta loja
  - name: dia-normal
    interval: 1m
    input_series:
      - series: 'http_requests_total{job="loja-api", rota="/checkout", status="200"}'
        values: '0+998x180'
      - series: 'http_requests_total{job="loja-api", rota="/checkout", status="500"}'
        values: '0+2x180'
    alert_rule_test:
      - eval_time: 3h
        alertname: CheckoutQueimandoOrcamentoRapido
        exp_alerts: []

  # um minuto inteiro de erro e volta ao normal: não pode acordar ninguém
  - name: pico-de-um-minuto
    interval: 1m
    input_series:
      - series: 'http_requests_total{job="loja-api", rota="/checkout", status="200"}'
        values: '0+998x120 119760 120758+998x60'
      - series: 'http_requests_total{job="loja-api", rota="/checkout", status="500"}'
        values: '0+2x120 1240+2x61'
    alert_rule_test:
      - eval_time: 2h3m
        alertname: CheckoutQueimandoOrcamentoRapido
        exp_alerts: []

  # checkout fora do ar a partir de 2h: a página tem que sair em minutos
  - name: queda-total
    interval: 1m
    input_series:
      - series: 'http_requests_total{job="loja-api", rota="/checkout", status="200"}'
        values: '0+998x120 119760+0x60'
      - series: 'http_requests_total{job="loja-api", rota="/checkout", status="500"}'
        values: '0+2x120 1240+1000x60'
    alert_rule_test:
      - eval_time: 2h6m
        alertname: CheckoutQueimandoOrcamentoRapido
        exp_alerts: []
      - eval_time: 2h7m
        alertname: CheckoutQueimandoOrcamentoRapido
        exp_alerts:
          - exp_labels:
              severity: page
            exp_annotations:
              summary: "Checkout com 12.04% de erro 5xx na última hora"
              description: "Clientes não conseguem pagar. Primeiro passo: ver se houve deploy nos últimos 60 min e o status do gateway."
              runbook_url: "https://github.com/SUA-ORGANIZACAO/runbooks/blob/main/checkout-5xx.md"
$ promtool check rules regras.yml
Checking regras.yml
  SUCCESS: 6 rules found

$ promtool test rules testes.yml
  SUCCESS
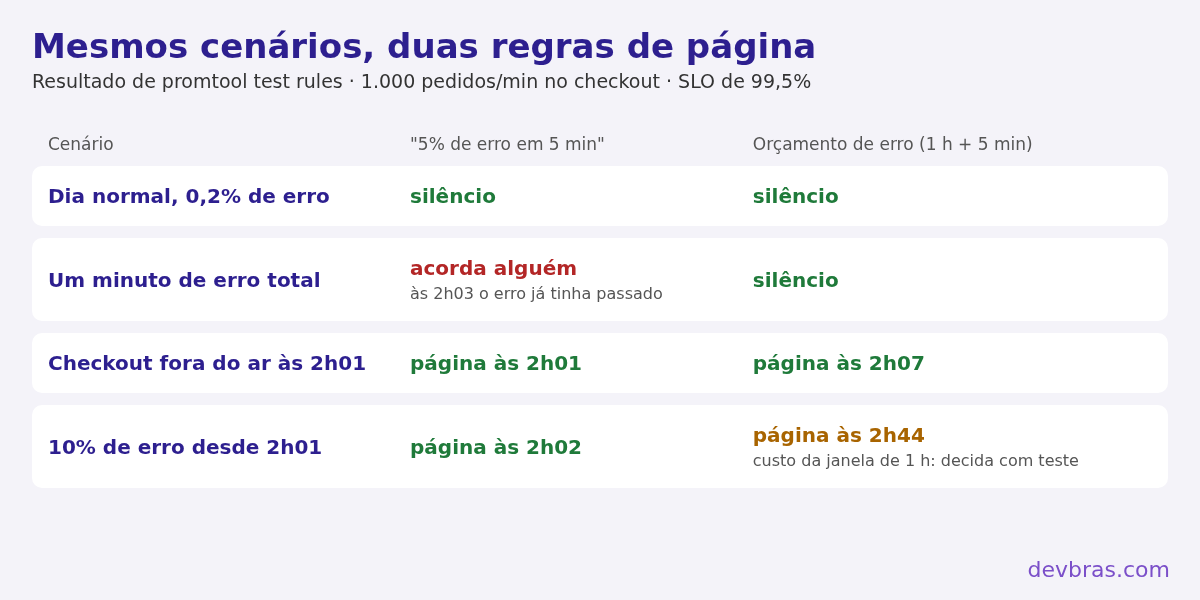
A notação 0+998x120 quer dizer "começa em 0 e soma 998 por minuto, 120 vezes". No cenário de queda, o checkout para às 2h01 e a página sai às 2h07, cerca de seis minutos depois, com a mensagem já dizendo 12% de erro na última hora. O dia normal e o pico de um minuto passam em silêncio.
Para comparar, a regra comum de "5% de erro em 5 minutos", sem duração e sem janela longa, rodada contra os mesmos testes:
- alert: CheckoutErroAltoIngenuo
  expr: |
    sum(rate(http_requests_total{rota="/checkout", status=~"5.."}[5m]))
    / sum(rate(http_requests_total{rota="/checkout"}[5m])) > 0.05
  labels:
    severity: page
$ promtool test rules testes-ingenua.yml
  FAILED:
    name: pico-de-um-minuto,
    alertname: CheckoutErroAltoIngenuo, time: 2h3m,
    ...
Às 2h03 ela estava disparando por um minuto ruim que já tinha passado. Esse é o ruído que ensina a ignorar.
O teste também mostra o custo da escolha. Num cenário extra com 10% de erro constante a partir das 2h, a página só saiu às 2h44 (a regra comum avisaria às 2h02): é o tempo que a média de uma hora leva para passar de 7,2%. Se 45 minutos de um em cada dez clientes sem conseguir pagar é inaceitável para a sua operação, acrescente a regra de seis horas citada acima ou aperte o objetivo, e rode os testes de novo para ver o efeito. Decidir isso com números de teste é bem melhor do que descobrir no incidente.
Roteamento que separa página de chamado
route:
  receiver: fila-chamados            # padrão: tudo que não for página vira chamado
  group_by: ["alertname", "job"]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers:
        - severity="page"
      receiver: plantao
      repeat_interval: 1h
    - matchers:
        - severity="info"
      receiver: nulo                 # vai para o painel, não notifica ninguém

inhibit_rules:
  # se o checkout já está acordando alguém, não mande também o chamado do mesmo problema
  - source_matchers:
      - alertname="CheckoutQueimandoOrcamentoRapido"
    target_matchers:
      - alertname="CheckoutQueimandoOrcamentoDevagar"
    equal: ["job"]

receivers:
  - name: plantao
    webhook_configs:
      - url: "http://127.0.0.1:9095/plantao"      # ponte para o app de plantão
  - name: fila-chamados
    webhook_configs:
      - url: "http://127.0.0.1:9095/chamados"     # ponte para a fila de chamados
  - name: nulo
A rota padrão é a fila de chamados, então um alerta novo sem severity nunca acorda ninguém por engano. O group_by junta as notificações da mesma regra e do mesmo serviço, para que trinta réplicas com o mesmo problema virem uma mensagem. A regra de inibição evita a notificação dupla quando os dois alertas do checkout disparam juntos, um problema que o próprio workbook aponta. Os campos estão descritos na documentação de configuração do Alertmanager. Os webhooks apontam para uma ponte local; troque pelo destino do seu app de plantão e da sua fila.
O amtool confere a sintaxe e mostra para onde cada combinação de rótulos vai:
$ amtool check-config alertmanager.yml
Checking 'alertmanager.yml'  SUCCESS

$ amtool config routes test --config.file=alertmanager.yml severity=page alertname=CheckoutQueimandoOrcamentoRapido
plantao
$ amtool config routes test --config.file=alertmanager.yml severity=ticket alertname=DiscoEnchendo
fila-chamados
$ amtool config routes test --config.file=alertmanager.yml severity=info alertname=CpuAlta
nulo
Coloque os testes no pipeline
Regras de alerta mudam junto com o sistema, e um rótulo renomeado na aplicação faz a regra parar de casar sem erro nenhum. Rode promtool check rules, promtool test rules e amtool check-config em todo pull request que mexa em regras.yml ou alertmanager.yml. Um cenário de teste novo para cada incidente real é a melhor forma de registrar o que o alerta deveria ter pegado.
Depois de cada incidente, vale olhar duas coisas: se a página saiu antes de alguém de fora avisar, e se ela mediu o que o cliente sentia. Um alerta baseado num healthcheck que só responde 200 pode ficar verde com o sistema parado. E o relatório do incidente sem culpado é o lugar de anotar a regra que faltou e o cenário de teste que a acompanha.
Referência: https://sre.google/sre-book/monitoring-distributed-systems/