Teste de restore: o backup que ninguém restaurou
Teste de restore de backup em SQLite com scripts testados: cópia sem o WAL, origem que mudou de caminho, backup parado e quanto tempo a volta leva.
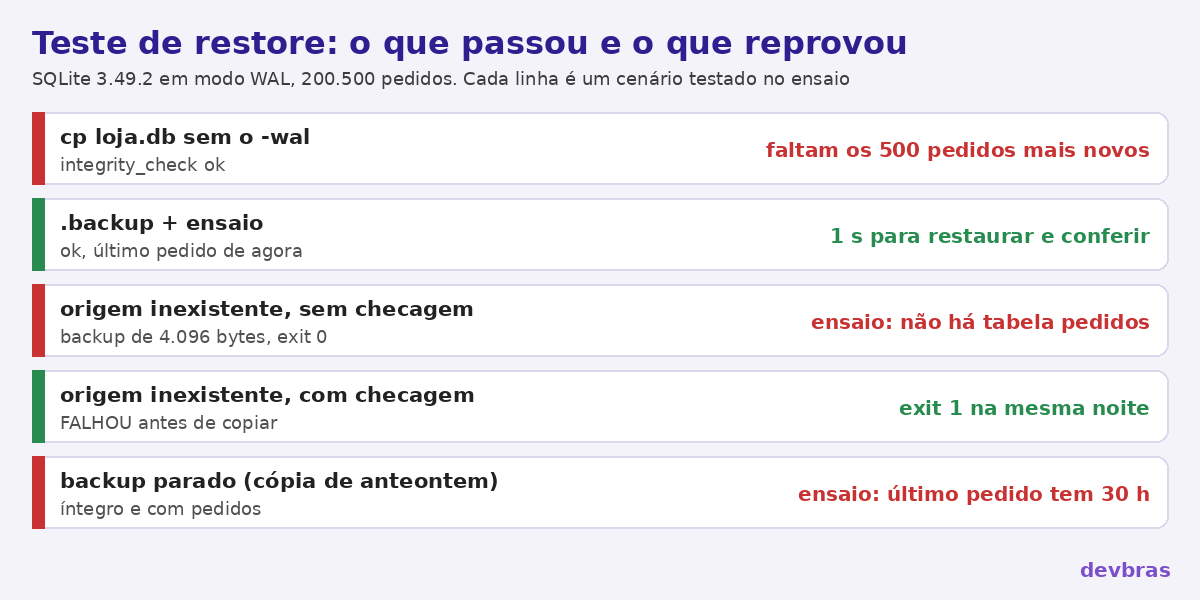
Na primeira rodada do teste de restore de um SQLite, o resultado foi este: um arquivo de backup de 4.096 bytes, código de saída 0 e nenhuma mensagem de erro. O comando era o .backup do próprio sqlite3, que é o jeito certo de copiar um SQLite com a aplicação no ar. O defeito estava no caminho de origem, que não existia mais. Quando recebe um caminho inexistente, o sqlite3 não reclama: cria um banco vazio ali mesmo e faz o backup desse banco vazio, com sucesso.
É a falha mais comum de todas. O sistema muda de pasta, o script continua apontando para o lugar antigo e o log diz "ok" toda madrugada. Ninguém percebe até o dia em que precisa do arquivo. O backup só existe de verdade depois que alguém restaura a cópia externa num lugar vazio e encontra nela um dado que sabe que estava lá.
Abaixo estão os dois scripts (backup e ensaio de restore) de uma loja com SQLite e os cenários em que eles foram testados, num container Alpine 3.22 com SQLite 3.49.2, rclone 1.69 e bash 5.2.
O banco de teste
A loja grava em /srv/loja/dados/loja.db, em modo WAL, com uma tabela pedidos. No teste, a tabela tinha 200.000 pedidos antigos, e a "aplicação" manteve uma conexão aberta e gravou mais 500 pedidos nos últimos minutos. Com a aplicação aberta, a pasta tinha três arquivos:
-rw-r--r-- 1 root root 10076160 loja.db
-rw-r--r-- 1 root root    32768 loja.db-shm
-rw-r--r-- 1 root root    32992 loja.db-wal
No modo WAL, como explica a documentação do SQLite sobre WAL, as alterações recentes ficam no arquivo -wal até o próximo checkpoint. Copiar só o loja.db com cp deu este resultado:
ok
200000|2026-10-29 22:04:54
O integrity_check respondeu "ok", e a cópia não tinha os 500 pedidos mais novos. O último pedido dela era de um dia e meio antes. Essa cópia passa em qualquer verificação de integridade e, mesmo assim, perde dados.
O script de backup
A API de backup online do SQLite, exposta no cliente de linha de comando como .backup, copia o banco página por página sem parar a aplicação e já inclui o conteúdo do WAL. O script tem uma linha que o original não tinha, a que confere se a origem existe:
#!/usr/bin/env bash
set -euo pipefail
ORIGEM=${ORIGEM:-/srv/loja/dados/loja.db}
DESTINO=/var/backups/loja
ARQ="$DESTINO/loja-$(date +%F-%H%M%S).db"

# sqlite3 cria um banco vazio quando o caminho não existe: confira antes
[ -s "$ORIGEM" ] || { echo "FALHOU: origem $ORIGEM não existe ou está vazia"; exit 1; }
mkdir -p "$DESTINO"
sqlite3 "$ORIGEM" ".backup '$ARQ'"
gzip "$ARQ"
rclone copy "$ARQ.gz" externo:loja/
find "$DESTINO" -name 'loja-*.db.gz' -mtime +7 -delete
echo "ok: $(basename "$ARQ.gz") $(stat -c %s "$ARQ.gz") bytes"
O set -euo pipefail faz o script parar no primeiro erro, em vez de seguir e apagar cópias antigas depois de uma falha. O rclone copy manda o arquivo para fora do servidor. No teste, externo: era um remoto do tipo alias apontando para outra pasta. Em produção, é um bucket ou uma conta de outro provedor. Localmente ficam só sete dias de cópias.
O ensaio de restore
O ensaio baixa a cópia mais nova do armazenamento externo, nunca a local, restaura numa pasta temporária, confere a integridade, procura o último pedido e mede a idade dele. Cada falha sai com código 1 e uma frase que diz o que falhou:
#!/usr/bin/env bash
set -euo pipefail
LIMITE_HORAS=${LIMITE_HORAS:-26}
TMP=$(mktemp -d)
trap 'rm -rf "$TMP"' EXIT
inicio=$(date +%s)

ULTIMO=$(rclone lsf externo:loja/ --include 'loja-*.db.gz' | sort | tail -n 1)
[ -n "$ULTIMO" ] || { echo "FALHOU: nenhum arquivo no armazenamento externo"; exit 1; }
rclone copy "externo:loja/$ULTIMO" "$TMP/"
gunzip -c "$TMP/$ULTIMO" > "$TMP/loja.db"

integridade=$(sqlite3 "$TMP/loja.db" "PRAGMA integrity_check;")
[ "$integridade" = "ok" ] || { echo "FALHOU: integridade de $ULTIMO: $integridade"; exit 1; }

ultimo_pedido=$(sqlite3 "$TMP/loja.db" "SELECT max(criado_em) FROM pedidos;" 2>&1) \
  || { echo "FALHOU: $ULTIMO abre, mas não tem a tabela pedidos ($ultimo_pedido)"; exit 1; }
[ -n "$ultimo_pedido" ] || { echo "FALHOU: $ULTIMO tem a tabela pedidos vazia"; exit 1; }

idade=$(( ( $(date +%s) - $(date -d "$ultimo_pedido" +%s) ) / 3600 ))
[ "$idade" -le "$LIMITE_HORAS" ] || { echo "FALHOU: último pedido tem ${idade} h ($ultimo_pedido)"; exit 1; }

fim=$(date +%s)
echo "$(date +%F) arquivo=$ULTIMO ultimo_pedido=$ultimo_pedido idade_h=$idade segundos=$((fim - inicio))" \
  | tee -a /var/log/ensaio-restore.log
Os nomes têm data no formato AAAA-MM-DD-HHMMSS, então a ordem alfabética é a mesma da cronológica, e o tail -n 1 pega o mais novo.
Os cenários do ensaio
Os horários abaixo são do container, em UTC.
Tudo certo
ok: loja-2026-10-31-033350.db.gz 1477564 bytes
2026-10-31 arquivo=loja-2026-10-31-033350.db.gz ultimo_pedido=2026-10-31 03:33:48 idade_h=0 segundos=1
O backup levou 0,29 s, e o restore com as conferências, cerca de 1 s. O último pedido da cópia é o último que a aplicação gravou, inclusive os que ainda estavam no WAL. Num banco de 10 MB, o tempo não diz muito. Num banco de 50 GB, esse número é o seu tempo de recuperação real, e é ele que deve ir para o runbook de restore, não a estimativa de alguém.
Origem mudou de caminho, com a checagem
FALHOU: origem /srv/loja/dados/loja-antigo.db não existe ou está vazia
Origem mudou de caminho, sem a checagem
Sem a linha do [ -s "$ORIGEM" ], o sqlite3 saiu com código 0, criou um nao-existe.db de 0 bytes na origem e um backup de 4.096 bytes no destino. Esse arquivo também passa no integrity_check. Quem pega o erro é a consulta do último pedido no ensaio:
FALHOU: loja-2099-01-01-000000.db.gz abre, mas não tem a tabela pedidos (Error: in prepare, no such table: pedidos)
Backup parado em silêncio
Com apenas uma cópia de anteontem no armazenamento externo, que é o que sobra quando o cron para de rodar, o arquivo está íntegro, tem a tabela e tem pedidos. O que o reprova é a idade:
FALHOU: último pedido tem 30 h (2026-10-29 21:33:51)
O limite de 26 horas cabe num backup diário com folga para atraso. Se o negócio não aguenta perder um dia de pedidos, o ensaio acabou de mostrar que o backup diário não basta. Essa conversa precisa acontecer antes do incidente.
As duas perguntas que o ensaio responde
Quem trabalha com recuperação fala em RPO e RTO. Na prática, são duas perguntas. Quanto dado eu perco? É a distância entre o último registro que voltou e o momento da perda, e o ensaio registra isso como idade_h. Quanto tempo fico parado? É o segundos, somado ao tempo de apontar a aplicação para o banco restaurado e testar um login.
Rode o ensaio automático toda semana, ou todo dia se for barato, e deixe o monitoramento avisar quando o código de saída for diferente de 0. Uma vez por trimestre, peça a alguém que não montou o backup para restaurar seguindo só o que está escrito. É nesse ensaio que aparecem a senha que ninguém sabe onde está e o passo que "todo mundo sabe".
O mesmo raciocínio vale para outros bancos, mudando só os comandos. Para MySQL, o post sobre backup de MySQL que restaura mostra o dump, e o teste de copiar a pasta data com o banco ligado mostra o equivalente do cp sem o WAL.
Referência: https://www.sqlite.org/backup.html