Rollback no Docker Compose: 4 falhas e o plano de volta
Rollback no Docker Compose posto à prova: redeploy que apaga a versão anterior, tag errada, imagem limpa pelo prune e coluna apagada que impede a volta.
Um rollback com Docker Compose costuma ser tratado como uma linha: trocar a tag e subir de novo. Quando a Equipe DevBras pôs o par de scripts de deploy e de volta à prova, com uma API de loja fictícia em três versões, a linha funcionou só no caso fácil. Nos outros, a volta subiu a versão errada sem dar erro, não achou a imagem ou pegou um banco que a versão anterior não sabia mais ler.
Este texto mostra os quatro cenários, os scripts corrigidos e o que precisa estar escrito antes do deploy para a volta ser um procedimento, e não uma aposta.
O cenário do ensaio
A loja roda com Compose num servidor só. A tag da imagem fica no .env ao lado do compose.yaml, e o serviço lê essa variável:
services:
  api:
    image: registry.lojadabia.com.br/loja/api:${API_TAG}
    restart: unless-stopped
    ports:
      - "127.0.0.1:8080:8080"
    volumes:
      - dados:/dados
volumes:
  dados:
São três versões. A 1.4.2 lê a coluna clientes.nome. A 1.5.0 cria nome_completo, copia os dados e passa a ler a coluna nova. A 1.6.0 apaga nome. Cada versão responde a própria tag em /versao, e é essa rota que prova qual código está no ar.
No primeiro ensaio, com Docker Engine 29.1.4 e Compose 5.6.1, o deploy da 1.4.2 para a 1.5.0, com o download da imagem, levou 10 segundos até a rota responder 1.5.0. Esse número só vale para uma imagem pequena num servidor ocioso. O seu precisa ser medido no seu ambiente.
Cenário 1: o redeploy que apaga a versão anterior
O script de deploy mais comum guarda a versão atual num arquivo antes de trocar:
ATUAL=$(grep '^API_TAG=' .env | cut -d= -f2)
echo "$ATUAL" > versao-anterior
sed -i "s/^API_TAG=.*/API_TAG=$NOVA/" .env
docker compose pull -q api
docker compose up -d api
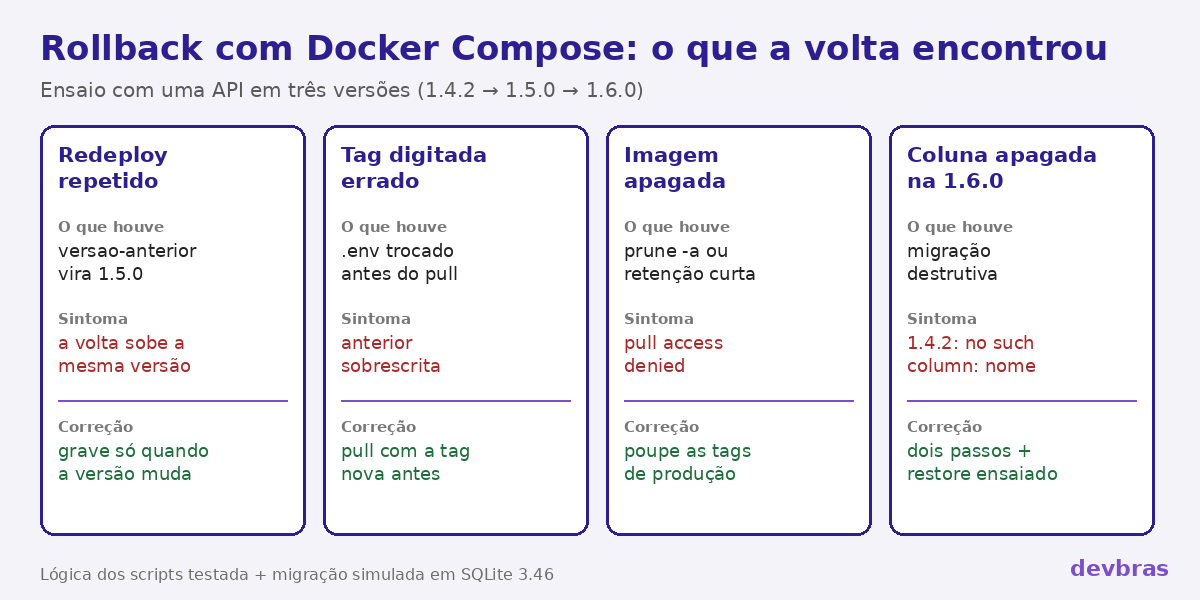
Ele parece certo até alguém rodar o deploy duas vezes com a mesma versão, para reiniciar o serviço ou porque o pipeline repetiu o job. Na segunda execução, a versão "atual" já é a 1.5.0, e o arquivo versao-anterior passa a dizer 1.5.0. A volta então "volta" para a própria 1.5.0 e responde sem erro:
versao-anterior: 1.5.0
no ar: 1.5.0
É o pior tipo de falha: o script termina com sucesso, a rota confirma a versão que ele mandou subir e o problema continua no ar. A correção é só gravar a anterior quando a versão muda de fato.
Cenário 2: a tag errada no meio do caminho
O mesmo script troca o .env antes de baixar a imagem. Com uma tag digitada errado, como 1.51 no lugar de 1.5.1, o pull falha, mas o arquivo já foi alterado e a versão anterior já foi sobrescrita. Qualquer docker compose up depois disso, até um reinício do servidor com restart: unless-stopped tentando recriar o container, tenta usar uma imagem que não existe.
O Compose dá prioridade à variável do shell sobre o .env, como explica a documentação de precedência de variáveis. Isso permite baixar a nova versão antes de mexer em qualquer arquivo. O deploy corrigido ficou assim:
#!/bin/sh
set -eu
cd /srv/loja
NOVA="$1"
ATUAL=$(grep '^API_TAG=' .env | cut -d= -f2)
# baixa a nova antes de mexer em qualquer coisa: se a tag não existe, para aqui
API_TAG="$NOVA" docker compose pull -q api
if [ "$ATUAL" = "$NOVA" ]; then
  echo "$NOVA já está no ar; versao-anterior continua $(cat versao-anterior 2>/dev/null)"
else
  echo "$ATUAL" > versao-anterior
  echo "$(date '+%F %T') $ATUAL -> $NOVA" >> historico-deploys
fi
sed -i "s/^API_TAG=.*/API_TAG=$NOVA/" .env
docker compose up -d api
./confere-versao.sh "$NOVA"
Com a tag errada, ele para no pull com exit 1, e o .env continua com API_TAG=1.4.2. No redeploy da mesma versão, ele avisa "1.5.0 já está no ar; versao-anterior continua 1.4.2", e a volta vai para a 1.4.2 de verdade. O arquivo historico-deploys fica com uma linha por troca, útil quando alguém pergunta o que estava no ar às 21h de sexta.
O confere-versao.sh substitui o sleep 10 seguido de curl, que é frágil dos dois lados: dez segundos podem sobrar ou faltar. Ele tenta a rota uma vez por segundo, por até 30 segundos, e falha mostrando as últimas linhas do log:
#!/bin/sh
ESPERADA="$1"
for i in $(seq 1 30); do
  if [ "$(curl -fsS -m 2 http://127.0.0.1:8080/versao 2>/dev/null)" = "$ESPERADA" ]; then
    echo "no ar: $ESPERADA em ${i}s"; exit 0
  fi
  sleep 1
done
echo "FALHOU: $ESPERADA não respondeu em 30 s" >&2
docker compose logs --tail 3 api >&2
exit 1
A volta usa o mesmo arquivo e a mesma conferência:
#!/bin/sh
set -eu
cd /srv/loja
ANTERIOR=$(cat versao-anterior)
sed -i "s/^API_TAG=.*/API_TAG=$ANTERIOR/" .env
docker compose up -d api
echo "$(date '+%F %T') volta para $ANTERIOR" >> historico-deploys
./confere-versao.sh "$ANTERIOR"
Cenário 3: a imagem anterior não existe mais
A volta depende de a 1.4.2 estar no servidor ou no registry. Uma limpeza agendada com docker image prune -a remove toda imagem que não está em uso por um container, como descreve a referência do comando. Depois do deploy da 1.5.0, a 1.4.2 é exatamente uma imagem sem container. Se o registry também tiver uma regra de retenção curta, a volta morre no primeiro passo:
pull access denied loja/api:1.4.2
exit 1
Duas regras evitam isso. No servidor, a limpeza poupa as tags que constam nas últimas linhas do historico-deploys, ou usa um filtro de idade (--filter "until=168h") maior que o tempo em que você ainda pode querer voltar. No registry, a retenção guarda pelo menos as últimas versões que foram para produção, não só as mais recentes construídas. Vale lembrar que uma tag como latest não serve como versão anterior, como mostramos em por que a tag latest não é versão.
Cenário 4: o banco que não volta junto
Trocar imagem leva segundos. Trocar dado não acontece trocando imagem. Foi o que a simulação das migrações mostrou, rodada no SQLite 3.46:
passo 1 (1.5.0, cria nome_completo):
  1.5.0 sobe | 1.4.2 sobe
passo 2 (1.6.0, apaga nome):
  1.6.0 sobe | 1.4.2 não sobe: no such column: nome
Depois da 1.5.0, voltar para a 1.4.2 é seguro, porque a coluna antiga continua lá. Depois da 1.6.0, a 1.4.2 nem inicia. Os scripts acima não ajudam nada nesse caso: a única saída é restaurar o backup e perder o que foi gravado desde a migração.
Esse é o padrão de mudança em dois tempos, que Martin Fowler descreve como parallel change (expandir, migrar, contrair). A release que muda o código só adiciona. A que remove vai sozinha, depois que a anterior ficou estável pelo tempo combinado, com backup feito logo antes e uma restauração já testada. O passo a passo da migração está em migração em dois passos, e o teste da restauração, em o backup que ninguém restaurou.
O plano de volta que vai junto com a release
Os quatro cenários cabem num bloco de texto curto, preenchido antes do deploy e guardado com a release:
Release: api 1.5.0          Anterior: api 1.4.2 (no registry e no servidor)
Banco: cria clientes.nome_completo e copia de nome. A 1.4.2 ignora a coluna nova.
Configuração: nova variável FRETE_URL. A 1.4.2 não lê; pode ficar.
Critério de volta: 5xx acima de 2% por 5 min ou falha no teste de checkout.
Como voltar: ./volta.sh (lê versao-anterior e confere /versao).
Dado que se perde na volta: nenhum.
Tempo de volta medido no ensaio: preencher com o número medido.
A linha mais importante é a do dado. "Pedidos feitos na 1.5.0 perdem o campo de frete" é uma resposta aceitável, desde que alguém tenha lido e concordado antes. "Não sei" quer dizer que a release ainda não está pronta. Para a 1.6.0, essa linha diz que não há volta por imagem, e o plano passa a ser o restore.
O ensaio que dá o número
Num ambiente com o mesmo processo de deploy e um banco de volume parecido, faça o deploy, gere alguns registros e rode ./volta.sh exatamente como está escrito. Cronometre da decisão até a rota responder a versão anterior e anote tudo o que precisou improvisar, porque cada improviso é uma linha que falta no plano. Repita a cada release que mexe em banco ou configuração.
Se as stacks estão espalhadas por vários servidores, o Dockyard, o painel Docker da DevBras, ajuda a ver a tag que cada serviço roda e o histórico do que subiu, o que deixa o plano de volta mais fácil de conferir. Os scripts continuam sendo a parte que precisa de ensaio.
Em resumo
- Grave a versão anterior só quando a versão muda, e baixe a nova antes de mexer no
.env. - Confira a volta pela rota que responde a versão, com tentativas, e não com um
sleepfixo. - Proteja da limpeza as imagens que estiveram em produção, no servidor e no registry.
- Separe a migração que remove da release que muda o código. Depois dela, a volta é restore, e o restore precisa estar ensaiado.
Referência: https://docs.github.com/en/actions/deployment/about-deployments