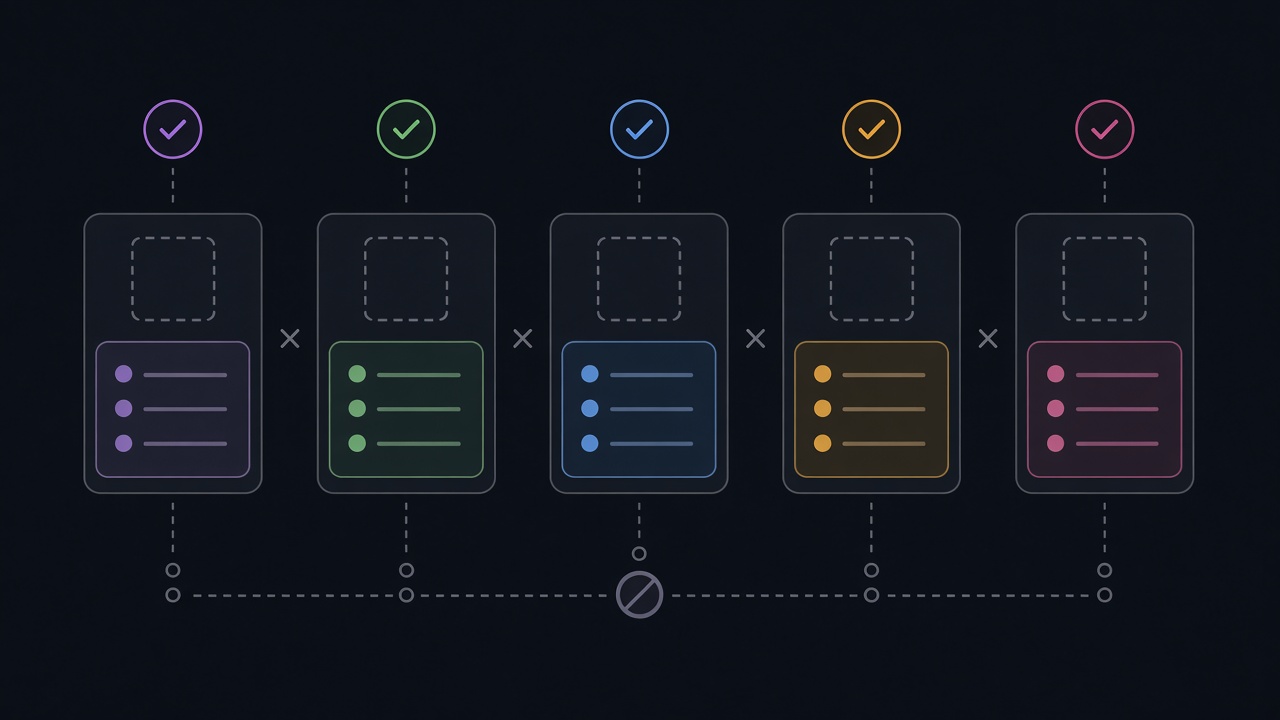
Teste que só passa sozinho: como achar e cortar o estado compartilhado
Descubra qual teste está vazando estado para o vizinho, rode a suíte em ordem aleatória e faça cada teste preparar e limpar o próprio dado.
Na sua máquina, pedidos.test.js passa sozinho. No CI, rodando com o resto da suíte, ele falha dizendo que o cliente "maria@exemplo.com" já existe. Ou o contrário: sozinho ele falha, porque dependia de uma linha que clientes.test.js inseria antes. A resposta curta: o teste está lendo ou deixando estado que não é dele. A correção é fazer cada teste criar o dado que usa, com identificador próprio, e devolver o ambiente ao estado limpo no fim, de preferência com uma transação desfeita. Para provar que funcionou, rode a suíte em ordem aleatória.
Isso não é "CI instável". A ordem dos testes nunca foi contrato. Quando ela muda, porque alguém renomeou um arquivo ou o executor passou a rodar em paralelo, o acoplamento que já existia aparece.
De onde vem o estado que vaza
Um teste bem isolado começa e termina no mesmo mundo. Ele vaza quando altera algo que sobrevive ao fim dele e que outro teste lê. Os suspeitos de sempre são poucos:
- Banco de dados compartilhado: linhas inseridas e não removidas, sequências que avançaram, um registro "admin" que um teste apaga e outro usa.
- Variáveis de módulo: um cache em memória, um singleton de configuração, um array exportado que os testes alteram.
- Relógio e ambiente: relógio falso não restaurado,
process.envalterado, fuso trocado. - Arquivos e portas: um arquivo temporário com nome fixo, um servidor de teste que ficou escutando na mesma porta.
- Mocks globais: um módulo substituído num teste e nunca devolvido ao original.
O padrão é sempre o mesmo: o teste A deixa uma marca, o teste B depende dela (ou tropeça nela), e a dependência só funciona quando A roda antes de B. Por isso o sintoma é intermitente. Ele depende da ordem e, em execução paralela, de quem chega primeiro.
Como encontrar o par acoplado
Antes de corrigir, descubra quem pisa em quem. Esse processo leva minutos e evita que você "conserte" o teste errado.
- Rode o teste que falha sozinho. Se passa sozinho e falha na suíte, alguém antes dele deixa sujeira. Se falha sozinho e passa na suíte, ele depende de algo que outro teste cria.
- Rode em ordem aleatória várias vezes. No Jest, a opção
--randomizeembaralha a ordem e mostra a semente usada; no Vitest, a configuraçãosequence.shufflefaz o mesmo; no pytest, o pluginpytest-randomlycumpre esse papel. Anote a semente da execução que falhou para repetir a mesma ordem. - Reduza pela metade. Rode o teste que falha junto com metade dos arquivos que vêm antes dele. Se falhar, o culpado está nessa metade; se não, está na outra. Em poucas rodadas você chega a um par.
- Leia o que o culpado altera e não desfaz. Quase sempre é uma linha no banco, uma variável de módulo ou um mock global.
Rodar de novo até passar é exatamente o que você não deve fazer. O post teste intermitente não se resolve clicando em rodar de novo trata do lado do processo: quem é dono do teste e quando colocá-lo em quarentena. Aqui o foco é a correção técnica.
Como isolar o banco de dados
No nosso exemplo, a loja tem dois arquivos de teste que usam o mesmo PostgreSQL. clientes.test.js cria "maria@exemplo.com" e não apaga. pedidos.test.js também cria "maria@exemplo.com" e espera sucesso. Quando a ordem muda, a restrição de e-mail único derruba o segundo.
Opção 1: uma transação por teste
Cada teste abre uma transação, faz o que precisa e, no fim, desfaz tudo com ROLLBACK. O banco volta exatamente ao estado anterior, e não sobra nada para o vizinho.
// pedidos.test.js
const { test, beforeEach, afterEach, after } = require('node:test');
const assert = require('node:assert/strict');
const { Pool } = require('pg');
const { criarCliente, criarPedido } = require('./loja');

const pool = new Pool({ connectionString: process.env.DATABASE_URL_TESTE });
let db;

beforeEach(async () => {
  db = await pool.connect();
  await db.query('BEGIN');
});

afterEach(async () => {
  await db.query('ROLLBACK');
  db.release();
});

after(() => pool.end());

test('pedido novo começa como pendente', async () => {
  const cliente = await criarCliente(db, { email: 'maria@exemplo.com' });
  const pedido = await criarPedido(db, { clienteId: cliente.id, totalCentavos: 15990 });
  assert.equal(pedido.status, 'pendente');
});
O detalhe que faz isso funcionar: o código testado precisa usar a mesma conexão que abriu a transação. Por isso criarCliente e criarPedido recebem db como parâmetro. Se o código pega outra conexão do pool por conta própria, ele não enxerga a transação e grava de verdade. Essa técnica também não serve quando o próprio código testado faz COMMIT ou abre conexões em paralelo; nesses casos, use a opção seguinte.
Opção 2: dados únicos e limpeza explícita
Quando a transação não cabe, por exemplo num teste de ponta a ponta que passa por uma API HTTP, cada teste gera seus próprios identificadores e apaga o que criou.
const { randomUUID } = require('node:crypto');

function emailUnico() {
  return 'teste-' + randomUUID() + '@exemplo.com';
}
Com e-mail único, dois testes nunca disputam o mesmo cliente, mesmo rodando em paralelo. A limpeza fica num afterEach que apaga pelos identificadores criados naquele teste, não com um DELETE geral que pode atingir dados de outro teste em execução.
Opção 3: banco descartável
Para suítes de integração mais pesadas, suba um banco novo por execução, com o esquema aplicado pelas mesmas migrações de produção. Ferramentas como Testcontainers fazem isso em várias linguagens. É mais lento que a transação, mas elimina sobras de execuções anteriores.
Estado em memória também vaza
Nem todo vazamento passa pelo banco. Um módulo que guarda cache em variável de topo mantém o valor entre testes do mesmo arquivo, e às vezes entre arquivos, dependendo do executor. A saída é a mesma: expor uma forma de criar uma instância nova por teste, em vez de exportar um objeto único já pronto. Se o módulo precisa ser global, ofereça uma função de reinício e chame no beforeEach.
Com process.env, guarde o valor original antes do teste e devolva depois. Com mocks e relógio falso, use as funções de restauração do executor num afterEach, não no fim do corpo do teste, porque o fim do corpo não roda quando uma asserção falha. O mesmo cuidado com o relógio aparece em teste que depende do relógio real.
Erros comuns
- Usar um usuário fixo de seed para tudo. Basta um teste alterar a senha ou apagar esse usuário para metade da suíte cair, sem relação com o que mudou.
- Limpar no fim do corpo do teste. Se uma asserção falha antes, a limpeza não roda e a falha se espalha para os seguintes.
- Apagar a tabela inteira entre testes paralelos. Um teste limpa o dado que o outro estava usando naquele instante, e o sintoma parece aleatório.
- Usar transação com código que abre a própria conexão. O teste parece isolado, mas o código grava fora da transação e deixa sobra.
- Desligar o paralelismo para "resolver". A suíte fica mais lenta e o acoplamento continua lá, esperando a próxima mudança de ordem.
- Depender de dados preparados por um arquivo de fixture enorme. Ninguém sabe qual teste usa qual linha; o post sobre fixture gigante mostra como montar só o que o teste precisa.
Checklist
- Cada teste passa rodando sozinho e passa rodando com a suíte inteira.
- A suíte passa em ordem aleatória em pelo menos cinco execuções seguidas.
- Testes de banco usam transação desfeita ou identificadores únicos.
- O código testado recebe a conexão em vez de pegar uma por conta própria.
- Limpeza de mocks, relógio e variáveis de ambiente fica em
afterEach. - Nenhum teste depende de um registro criado por outro arquivo.
- A semente de uma execução aleatória que falhou é registrada para reprodução.
Rode a sua suíte agora com a ordem embaralhada três vezes seguidas: ela passa nas três, ou alguma semente mostra qual teste estava encostado no vizinho?
Referência: https://martinfowler.com/bliki/TestDouble.html