Teste flaky no CI: por que rerodar esconde o bug
Teste flaky medido numa simulação de mil execuções: por que a espera fixa falha, como medir a taxa, montar quarentena no GitHub Actions e provar o conserto.
Um teste que falha 6,6% das vezes parece pouco. Quem clica em "Re-run" vê o verde na segunda tentativa em cerca de 93% das vezes, e duas falhas seguidas acontecem em menos de 0,5% das rodadas. O pipeline fica verde e o merge entra. O problema é o que esse clique ensina: que vermelho pode ser ignorado. No dia em que o mesmo teste falhar por um bug de verdade, alguém vai clicar de novo, e a chance de o bug passar junto é real.
Este texto parte de uma simulação pequena, com o tipo de espera que mais gera teste flaky, e segue com o que fazer: medir a taxa, tirar o teste da trava do merge sem esquecê-lo, achar a causa e provar o conserto.
O tamanho do problema, com números de quem mediu
O Google publicou em 2016, no blog de testes da empresa, os números da própria base de código. Cerca de 1,5% de todas as execuções de teste davam resultado flaky, ou seja, passavam e falhavam com o mesmo código. Quase 16% dos testes tinham algum grau de instabilidade. E cerca de 84% das transições de "passou" para "falhou" no CI envolviam um teste flaky, e não um bug novo.
A última métrica é a que mais pesa no dia a dia. Se quatro em cada cinco vermelhos são ruído, o time aprende a não ler o erro. A conta piora com o tamanho da suíte: 20 testes independentes que falham sozinhos 2% das vezes deixam a suíte inteira verde em só 0,98 elevado a 20, cerca de 67% das rodadas. Um terço dos pipelines fica vermelho sem nenhum bug.
A simulação: a espera fixa contra a espera pela condição
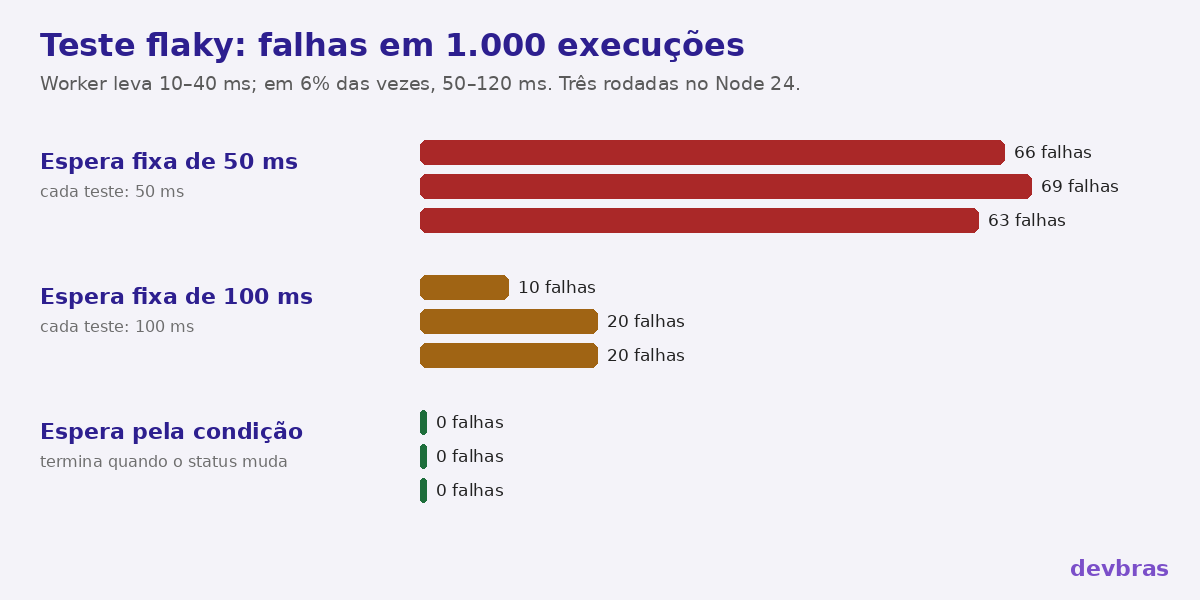
O caso mais comum é o teste que dispara algo assíncrono e espera um tempo fixo antes de conferir. No exemplo, um worker marca o pedido como pago. Quase sempre ele leva de 10 a 40 ms, mas em 6% das vezes, como num runner de CI ocupado, leva de 50 a 120 ms. O script roda mil testes de cada jeito no Node:
// Simula o worker que marca o pedido como pago: quase sempre em 10-40 ms,
// mas em 6% das vezes (runner ocupado) leva de 50 a 120 ms
// e compara a espera fixa de 50 ms com a espera pela condição (prazo de 500 ms).
const dorme = (ms) => new Promise((r) => setTimeout(r, ms));

function criaPedido() {
  const pedido = { status: 'pendente' };
  const atraso = Math.random() < 0.06 ? 50 + Math.random() * 70 : 10 + Math.random() * 30;
  setTimeout(() => { pedido.status = 'pago'; }, atraso);
  return pedido;
}

async function esperarAte(condicao, { timeoutMs = 500, intervaloMs = 5 } = {}) {
  const limite = Date.now() + timeoutMs;
  while (Date.now() < limite) {
    if (await condicao()) return;
    await dorme(intervaloMs);
  }
  throw new Error('condição não atingida em ' + timeoutMs + ' ms');
}

async function testeEsperaFixa() {
  const p = criaPedido(); await dorme(50); return p.status === 'pago';
}
async function testeEsperaFixaMaior() {
  const p = criaPedido(); await dorme(100); return p.status === 'pago';
}
async function testeEsperaCondicao() {
  const p = criaPedido();
  try { await esperarAte(() => p.status === 'pago'); return true; } catch { return false; }
}

for (const [nome, teste] of [['espera fixa de 50 ms', testeEsperaFixa], ['espera fixa de 100 ms', testeEsperaFixaMaior], ['espera pela condição', testeEsperaCondicao]]) {
  const ini = Date.now();
  const resultados = await Promise.all(Array.from({ length: 1000 }, teste));
  const falhas = resultados.filter((ok) => !ok).length;
  console.log(`${nome}: ${falhas} falhas em 1000 (${Date.now() - ini} ms no total)`);
}
Três execuções no Node 24 deram este resultado:
espera fixa de 50 ms: 66 falhas em 1000 (57 ms no total)
espera fixa de 100 ms: 10 falhas em 1000 (102 ms no total)
espera pela condição: 0 falhas em 1000 (125 ms no total)
espera fixa de 50 ms: 69 falhas em 1000 (54 ms no total)
espera fixa de 100 ms: 20 falhas em 1000 (103 ms no total)
espera pela condição: 0 falhas em 1000 (121 ms no total)
espera fixa de 50 ms: 63 falhas em 1000 (54 ms no total)
espera fixa de 100 ms: 20 falhas em 1000 (103 ms no total)
espera pela condição: 0 falhas em 1000 (120 ms no total)
A espera de 50 ms falhou em 63 a 69 de cada mil testes. Dobrar para 100 ms, o conserto que todo mundo tenta primeiro, ainda deixou de 10 a 20 falhas, e cada teste passou a custar 100 ms mesmo quando o worker terminava em 15. A espera pela condição não falhou nenhuma vez e termina assim que o status muda. Se a condição nunca chega, ela falha com uma mensagem que diz o que faltou, em vez de uma asserção confusa.
No teste real, com a API, o formato é o mesmo:
test('pedido muda para pago', async () => {
  await api.post('/pedidos/42/pagar');
  await esperarAte(async () => {
    const pedido = await api.get('/pedidos/42');
    return pedido.status === 'pago';
  }, { timeoutMs: 5000, intervaloMs: 50 });
});
Medir antes de mexer
"Falha de vez em quando" não ajuda a priorizar nem a saber se o conserto funcionou. Rode o teste sozinho várias vezes no mesmo commit e conte:
falhas=0
for i in $(seq 1 50); do
  npx jest tests/checkout.test.js --silent > /dev/null 2>&1 || { falhas=$((falhas + 1)); echo "falhou na rodada $i"; }
done
echo "total: $falhas falhas em 50"
Se ele passa 50 de 50 sozinho e falha na suíte completa, a suspeita muda para ordem ou recurso compartilhado. O Jest tem a opção --randomize, que embaralha os testes dentro de cada arquivo e mostra a semente usada, e --seed para repetir a mesma ordem, como descreve a documentação da CLI do Jest. No pytest, o plugin pytest-randomly faz o mesmo. Anote a semente que reproduz a falha: com ela, o problema deixa de ser aleatório.
As causas, na ordem em que costumam aparecer
- Espera fixa por algo assíncrono. O caso da simulação. Troque o
sleeppela condição com prazo. - Relógio real. Teste que passa de dia e falha perto da meia-noite, no último dia do mês ou em outro fuso. O conserto é controlar o tempo no teste, como em teste que depende do relógio.
- Ordem e estado compartilhado. Um teste deixa um registro no banco, e outro só passa se rodar depois dele. Em paralelo, dois testes usam a mesma porta, o mesmo arquivo temporário ou a mesma tabela. O roteiro está em teste que pisa em outro.
- Mundo externo. API de terceiro, DNS ou fila real. Se o teste depende de algo fora do seu controle, ele mede a internet, não o seu código. Um dublê precisa se comportar como o serviço de verdade, ou cria outro tipo de erro, como mostramos em mock que mente.
Quarentena que não vira cemitério
Enquanto a causa não aparece, o teste sai da trava do merge, mas continua rodando. No GitHub Actions, um job separado com continue-on-error: true, opção descrita na referência de sintaxe de workflow, mantém a falha visível sem bloquear ninguém:
jobs:
  testes:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - run: npm ci
      - run: npx jest --testPathIgnorePatterns=tests/quarentena
  quarentena:
    runs-on: ubuntu-latest
    continue-on-error: true
    steps:
      - uses: actions/checkout@v7
      - run: npm ci
      - run: npx jest tests/quarentena
Na proteção de branch, só o job testes fica obrigatório. Três regras evitam que a pasta de quarentena vire o lugar onde os testes morrem: cada teste ali tem um chamado com o log da falha, a taxa medida e um dono; a pasta tem um limite, por exemplo cinco testes, e passar dele significa parar e consertar; e o teste só volta ao job obrigatório depois de passar as mesmas 50 rodadas sem falha.
O rerun automático conta como falha
Algumas ferramentas repetem sozinhas o teste que falhou. O próprio Jest tem jest.retryTimes. Usar isso como amortecedor pode até fazer sentido, desde que cada repetição fique registrada. Um teste que só passou na segunda tentativa é um teste instável, não um teste verde. Se o painel mostra 100% verde enquanto as repetições crescem, o problema está sendo escondido, não resolvido.
O objetivo de tudo isso é simples de dizer: vermelho precisa voltar a significar "tem problema aqui". Um teste em que ninguém acredita é pior que nenhum, porque gasta o tempo do CI e ainda treina o time a ignorar o alarme.
Referência: https://testing.googleblog.com/2016/05/flaky-tests-at-google-and-how-we.html