Timeout em chamadas HTTP: o prazo que corta de verdade
Timeout em chamadas HTTP testado em requests, aiohttp e fetch: por que timeout=(3, 5) deixou passar 21 s, como pôr prazo total e repetir só o que pode repetir.
A API de frete de uma loja virtual não cai: ela fica lenta. Responde em 8 segundos em vez de 300 milissegundos. O checkout continua de pé, mas cada visitante que chega à etapa do frete prende uma conexão do servidor por 8 segundos. Ele atualiza a página, e agora são duas conexões presas. Com cem pessoas comprando, o pool de conexões acaba, e páginas que nem usam frete, como a busca e o login, começam a esperar na fila. A loja cai por causa do servidor de outra empresa.
O antídoto é um timeout de verdade em toda chamada que sai do seu processo: HTTP, banco, cache, fila, e-mail. Mas "de verdade" tem um detalhe que pega muita gente. Para mostrar esse detalhe, montamos uma dependência de mentira em Python e testamos contra ela os clientes mais comuns, com Python 3.13, requests 2.34, aiohttp 3.14 e Node 24.
A dependência de mentira
O servidor de teste tem três rotas. /frete espera 8 segundos antes de responder. /gotejando manda o cabeçalho na hora e depois o corpo de 22 bytes, um byte por segundo, que é o comportamento de um servidor sobrecarregado ou de um proxy engasgado. /cotacao devolve 503 nas duas primeiras chamadas e responde normalmente na terceira. Os resultados:
- requests sem timeout, /frete: esperou os 8 s inteiros. Se o servidor nunca respondesse, esperaria para sempre. A documentação do requests diz isso: sem
timeout, não há prazo. - requests com timeout=(3, 5), /frete:
ReadTimeoutem 5,0 s. Até aqui, tudo como esperado. - requests com timeout=(3, 5), /gotejando: respondeu, em 21 segundos. Nenhum erro.
- fetch com AbortSignal.timeout(2500), /frete e /gotejando: cancelou nas duas em 2,5 s.
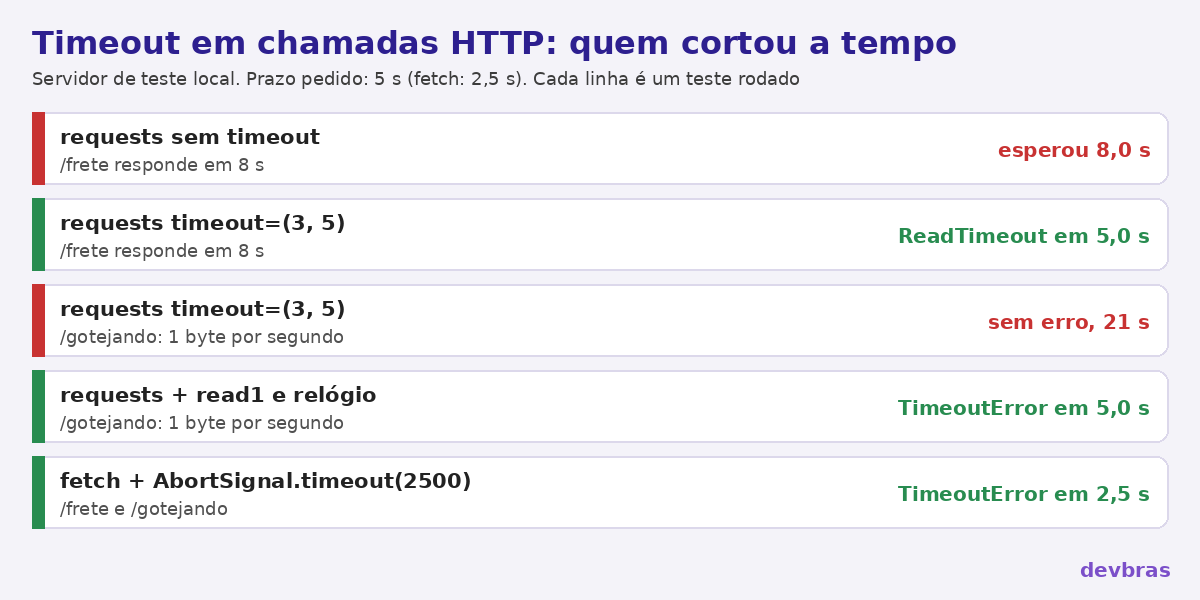
O terceiro resultado é o que importa. No requests, o segundo número da tupla é o tempo máximo entre dois pacotes recebidos, não o tempo total da resposta. Um servidor que pinga um byte a cada segundo nunca fica 5 segundos calado, então o prazo nunca estoura. O mesmo vale para muitos clientes HTTP que separam o prazo de conexão do prazo de leitura. Para uma página web, o número que importa é o total.
Prazo total no Node, com fetch
No Node e no navegador, AbortSignal.timeout cria um sinal que cancela a operação depois do prazo. Passado ao fetch, ele cobre a requisição inteira, inclusive a leitura do corpo com resposta.json(), como o teste com /gotejando confirmou. No estouro, o erro tem name igual a TimeoutError, o que separa o timeout dos outros erros de rede:
let timeoutsFrete = 0;

async function calcularFrete(cep) {
  const url = process.env.FRETE_URL + '/frete?cep=' + encodeURIComponent(cep);
  try {
    const resposta = await fetch(url, { signal: AbortSignal.timeout(2500) });
    if (!resposta.ok) throw new Error('Frete respondeu HTTP ' + resposta.status);
    return await resposta.json();
  } catch (erro) {
    if (erro.name === 'TimeoutError') {
      timeoutsFrete++;
      console.warn('Frete passou de 2,5 s', { cep, total: timeoutsFrete });
      return null;
    }
    throw erro;
  }
}
Quem chama trata o null como "frete indisponível no momento", mostra isso na tela e oferece tentar de novo. O contador é o mínimo. Em produção, mande esse número para a ferramenta de métricas, porque um aumento de timeouts é o primeiro sinal de que a dependência está degradando, e marque cada chamada com um correlation id para achar o pedido nos logs dos dois lados.
Prazo total em Python
O requests não tem opção de prazo total. A primeira versão do contorno que testamos lia a resposta com iter_content(chunk_size=1024) e conferia o relógio a cada pedaço. Não funcionou: o iter_content espera juntar 1.024 bytes, ou o corpo acabar, antes de devolver qualquer coisa, e a chamada levou os mesmos 21 s. A versão que funcionou lê com read1, que devolve o que já chegou:
import time, requests

def get_com_prazo_total(url, total, conectar=3):
    """Prazo total com requests: lê o que chegar e confere o relógio a cada pedaço."""
    limite = time.monotonic() + total
    with requests.get(url, stream=True, timeout=(conectar, total)) as r:
        r.raise_for_status()
        partes = []
        while parte := r.raw.read1(64 * 1024):
            partes.append(parte)
            if time.monotonic() > limite:
                raise TimeoutError(f"{url} passou de {total} s")
        return b"".join(partes)
Contra /gotejando, com prazo total de 5 s, ela levantou TimeoutError em 5,0 s. Quem pode usar código assíncrono tem uma alternativa pronta: o aiohttp aceita ClientTimeout(total=5, connect=3), que no teste cortou as duas rotas lentas em cerca de 6 s.
Nas outras linguagens, o raciocínio é o mesmo: descubra se o prazo da biblioteca é total ou por operação. No PHP com cURL, CURLOPT_CONNECTTIMEOUT é só a conexão e CURLOPT_TIMEOUT é a operação inteira. No .NET, a propriedade HttpClient.Timeout vale 100 segundos por padrão, e nenhuma pessoa espera 100 segundos olhando um checkout. Essas duas não foram testadas aqui. Não esqueça do banco e do cache: os drivers costumam ter opções separadas para o tempo de conexão e o de consulta, e uma consulta presa segura uma conexão do pool do mesmo jeito que uma API lenta segura uma thread.
Como escolher o número
- Meça o normal. Use o percentil alto do tempo de resposta da dependência, como o p99, e não a média.
- Dê folga. Um prazo um pouco acima do p99 deixa passar as chamadas lentas legítimas e corta as que travaram.
- Respeite o orçamento da página. Se a página precisa responder em 3 segundos e chama duas APIs em sequência, cada uma não pode ter 5 segundos.
- Fique abaixo do proxy. No Nginx, o proxy_read_timeout padrão é de 60 segundos. Se o seu código espera mais que isso, o visitante já recebeu um 504 e o seu processo continua trabalhando para ninguém.
- Decida o que acontece no estouro. Mensagem, valor padrão, versão em cache ou tentativa mais tarde. Isso é decisão de produto.
Repetir, mas só o que pode repetir
Depois de um timeout, você não sabe se a operação aconteceu do outro lado. Por isso a repetição automática só é segura em operações idempotentes, como leituras, cotações e buscas. Repetir uma cobrança ou a criação de um pedido sem proteção gera duplicata, e para essas o caminho é a chave descrita em idempotência no pagamento.
Mesmo em leituras, repita pouco e com espera crescente e um pouco de aleatoriedade, para que todos os servidores não martelem a dependência no mesmo instante em que ela tenta se recuperar:
async function comRepeticao(funcao, tentativas = 2) {
  for (let i = 0; i <= tentativas; i++) {
    try {
      return await funcao();
    } catch (erro) {
      if (i === tentativas) throw erro;
      const espera = 200 * 2 ** i + Math.random() * 100;
      await new Promise((resolver) => setTimeout(resolver, espera));
    }
  }
}

const cotacao = await comRepeticao(() =>
  fetch(process.env.COTACAO_URL + '/cotacao/USD', { signal: AbortSignal.timeout(2000) })
    .then((r) => {
      if (!r.ok) throw new Error('HTTP ' + r.status);
      return r.json();
    })
);
Contra /cotacao, as duas primeiras tentativas receberam 503, com esperas de 245 ms e 475 ms, e a terceira trouxe a cotação, em 0,7 s no total. Cada tentativa ganha o próprio sinal de 2 segundos, porque o AbortSignal.timeout é criado dentro da função repetida. No pior caso, são três prazos de 2 s mais as esperas, ou seja, mais de 6 segundos. Se isso estoura o orçamento da página, reduza as tentativas. Se a dependência responde 429, respeite o cabeçalho de espera que ela mandar, como explica o post sobre rate limit que avisa.
Para achar as chamadas sem prazo num projeto, procure por fetch(, requests., curl_init e new HttpClient e confira uma por uma se o prazo é explícito e total.
Referência: https://developer.mozilla.org/docs/Web/API/AbortSignal