GitHub Actions: como cortar os minutos do CI
Corte os minutos do GitHub Actions: um gatilho só, cancelamento no PR, matriz cheia só na main, ubuntu-slim, cache e timeout, sem travar checagem.
Em repositório privado, todo job em runner hospedado pelo GitHub consome minutos do plano, e cada job é arredondado para o minuto inteiro de cima. Um lint de 20 segundos conta 1 minuto. Uma matriz de 9 combinações que roda em todo push conta 9 jobs, e um terço deles em macOS, cujo minuto custa mais de 10 vezes o do Linux. Este post é sobre o workflow: onde os minutos somem e como cortar sem perder o que protege o merge. Para estimar a fatura e configurar orçamento e alerta, o guia é o de preço do GitHub Actions.
Meça antes de mexer
Abra uma execução recente do workflow principal e, na barra lateral, em Run details, clique em Usage. A página Viewing job execution time explica que ali aparece o tempo cobrável de cada job, já arredondado. Anote três números: quantos jobs a execução teve, quanto durou cada um e em que sistema rodou. Depois conte quantas execuções o workflow teve no mês, na aba Actions.
Com isso, a conta é jobs × minutos arredondados × execuções, separada por sistema. Os preços por minuto dos runners padrão, na tabela do GitHub consultada em 26/10/2026, são US$ 0,002 no Linux de 1 núcleo (ubuntu-slim), US$ 0,006 no Linux de 2 núcleos, US$ 0,010 no Windows e US$ 0,062 no macOS.
O workflow que gasta demais
Este é um CI de projeto Node bem comum, e ele está correto. Só que roda tudo, sempre:
name: ci
on: [push, pull_request]
jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - run: npm ci && npm run lint
  testes:
    runs-on: ${{ matrix.os }}
    strategy:
      matrix:
        os: [ubuntu-latest, windows-latest, macos-latest]
        node: [20, 22, 24]
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with:
          node-version: ${{ matrix.node }}
      - run: npm ci
      - run: npm test
Três coisas multiplicam a conta:
on: [push, pull_request]faz cada push numa branch com PR aberto rodar duas vezes: uma pelo eventopushe outra pelopull_request.- A matriz de 3 sistemas × 3 versões roda em todo push de PR, mesmo quando a pessoa ainda está no terceiro commit de ajuste.
- Nenhum job tem
timeout-minutes. O padrão, segundo a sintaxe de workflow, é 360 minutos. Um teste travado num runner macOS pode rodar seis horas: 360 × US$ 0,062 = US$ 22,32 por job travado.
O mesmo CI, cortado
name: ci
on:
  pull_request:
    paths-ignore:
      - "docs/**"
      - "**/*.md"
  push:
    branches: [main]

concurrency:
  group: ci-${{ github.workflow }}-${{ github.event.pull_request.number || github.ref }}
  cancel-in-progress: ${{ github.event_name == 'pull_request' }}

jobs:
  lint:
    runs-on: ubuntu-slim
    timeout-minutes: 5
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with:
          node-version: 24
          cache: npm
      - run: npm ci
      - run: npm run lint

  testes:
    runs-on: ${{ matrix.os }}
    timeout-minutes: 15
    strategy:
      fail-fast: true
      matrix:
        os: ${{ github.event_name == 'pull_request' && fromJSON('["ubuntu-latest"]') || fromJSON('["ubuntu-latest","windows-latest","macos-latest"]') }}
        node: ${{ github.event_name == 'pull_request' && fromJSON('[24]') || fromJSON('[20,22,24]') }}
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with:
          node-version: ${{ matrix.node }}
          cache: npm
      - run: npm ci
      - run: npm test
Linha por linha, o que mudou e por quê.
Um gatilho por mudança
O pull_request cobre o trabalho em andamento e o push fica restrito à main, para testar o resultado do merge. Acabou a execução dupla.
Cancelar o que ficou velho, só no PR
O grupo de concurrency junta as execuções do mesmo PR. Quando chega um push novo, a execução anterior é cancelada, porque o resultado dela não vale mais nada. O cancel-in-progress aceita uma expressão; aqui ele só é verdadeiro em pull_request, para que cada merge na main seja testado até o fim.
Matriz cheia só onde ela decide
No PR, a matriz vira um job: Linux com o Node que roda em produção. A combinação completa de sistemas e versões roda no push da main. A troca é consciente: um problema que só aparece no Windows será pego depois do merge, e não antes. Se o seu produto é instalado em Windows por clientes, inclua o Windows no PR e corte outra coisa.
Job pequeno em runner pequeno
O lint foi para o ubuntu-slim, que tem 1 CPU e 5 GB de memória e custa um terço do minuto do Linux padrão. A documentação dos runners hospedados avisa que jobs em runner de 1 CPU têm limite de 15 minutos e falham se passarem disso. Serve para lint, checagem de formato e scripts curtos. Teste e build continuam no runner padrão.
Cache e timeout
O cache: npm do setup-node guarda o cache de download do npm entre execuções, então o npm ci deixa de baixar todos os pacotes a cada vez. Pela página de cache de dependências, cada repositório tem 10 GB por padrão e entradas sem acesso há mais de 7 dias são removidas. Por fim, todo job ganhou timeout-minutes com folga sobre a duração normal: 5 para o lint e 15 para os testes.
O cuidado com o filtro de caminho
O paths-ignore faz um PR que só mexe em docs/ ou em arquivos .md não rodar o CI. Mas, se o lint e os testes forem checagens obrigatórias na proteção da branch, esse PR fica travado. A página de problemas com checagens obrigatórias explica: workflow pulado por filtro de caminho, de branch ou por mensagem de commit deixa as checagens em Pending, e o merge não acontece.
Há duas saídas. A primeira é não tornar obrigatório um workflow que pode ser pulado. A segunda é tirar o filtro do on: e decidir dentro do workflow: um primeiro job descobre quais arquivos mudaram (a ação dorny/paths-filter faz isso) e os outros usam if: com o resultado. Segundo a mesma página, job pulado por condição reporta Success e não bloqueia o merge.
A mesma regra vale para quem usa [skip ci] na mensagem do commit. A página Skipping workflow runs lista as variações aceitas ([skip ci], [ci skip], [no ci], [skip actions] e [actions skip]), que só valem para os eventos push e pull_request e também deixam checagens obrigatórias pendentes.
Quanto cai, num cenário de exemplo
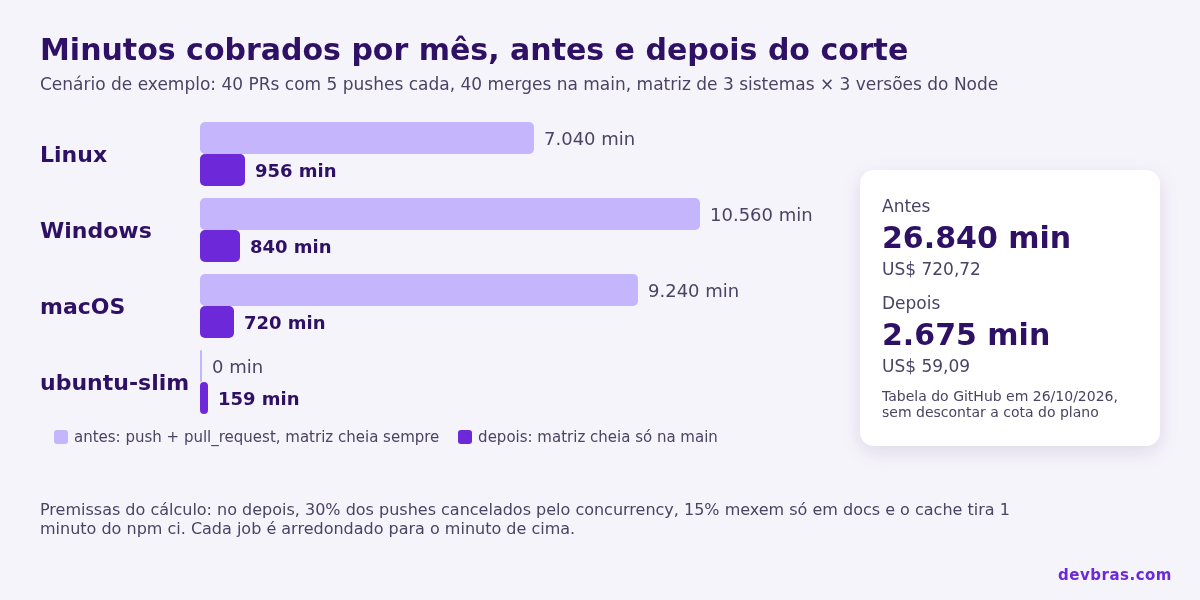
Para ter uma ordem de grandeza, este script calcula o mês de um repositório hipotético: 40 PRs com 5 pushes cada e 40 merges. As durações dos jobs e os percentuais de corte são premissas, marcadas no código; troque pelos números que você anotou na página de Usage.
# Estima minutos cobrados por mês (cada job é arredondado para cima, como o GitHub faz)
from math import ceil
PRECO = {"slim": 0.002, "linux": 0.006, "windows": 0.010, "macos": 0.062}  # US$/min, tabela do GitHub em 26/10/2026
DUR = {"linux": 4.2, "windows": 7.5, "macos": 6.1}   # minutos medidos por job de teste (exemplo)

def mes(execucoes, jobs):
    tot = {}
    for so, dur, n in jobs:
        tot[so] = tot.get(so, 0) + execucoes * n * ceil(dur)
    return tot

prs, pushes_por_pr, merges = 40, 5, 40
# ANTES: on: [push, pull_request] -> cada push num PR roda 2 vezes; matriz 3x3 sempre; lint em ubuntu-latest
exec_antes = prs * pushes_por_pr * 2 + merges
antes = mes(exec_antes, [("linux", 0.4, 1), ("linux", DUR["linux"], 3),
                         ("windows", DUR["windows"], 3), ("macos", DUR["macos"], 3)])
# DEPOIS: só pull_request + push na main; 30% dos pushes cancelados pelo concurrency;
# 15% dos pushes só mexem em docs; cache tira ~1 min do npm ci; PR roda só Linux/Node 24
exec_pr = round(prs * pushes_por_pr * (1 - 0.30) * (1 - 0.15))
pr = mes(exec_pr, [("slim", 0.4, 1), ("linux", DUR["linux"] - 1, 1)])
main = mes(merges, [("slim", 0.4, 1), ("linux", DUR["linux"] - 1, 3),
                    ("windows", DUR["windows"] - 1, 3), ("macos", DUR["macos"] - 1, 3)])
depois = {k: pr.get(k, 0) + main.get(k, 0) for k in set(pr) | set(main)}

for nome, t, ex in (("antes", antes, exec_antes), ("depois", depois, exec_pr + merges)):
    custo = sum(PRECO[k] * v for k, v in t.items())
    print(f"{nome:7} execuções={ex:4}  " + "  ".join(f"{k}={t.get(k,0):5}" for k in PRECO)
          + f"  total={sum(t.values()):5} min  US$ {custo:7.2f}")
antes   execuções= 440  slim=    0  linux= 7040  windows=10560  macos= 9240  total=26840 min  US$  720.72
depois  execuções= 159  slim=  159  linux=  956  windows=  840  macos=  720  total= 2675 min  US$   59.09
No exemplo, os minutos caem de 26.840 para 2.675 e a conta, antes de descontar a cota do plano, de US$ 720,72 para US$ 59,09. A maior parte da economia vem de tirar Windows e macOS do PR, porque são os minutos mais caros. O cancelamento e o filtro de caminho ajudam menos, mas não custam nada.
Depois do corte
Teste instável que obriga a rodar o workflow de novo também gasta minutos, e o conserto é outro: está em teste flaky não se resolve rerodando. Já trocar por um runner auto-hospedado para fugir da cobrança tem outro preço: o job passa a rodar com o acesso daquela máquina, como mostra runner self-hosted no notebook.