Alerta crítico só por e-mail falha junto com o e-mail
O alarme de cloro de um hotel na Alemanha foi só por e-mail no dia em que o Outlook caiu. Dois caminhos e um heartbeat, testados no Alertmanager.
Na sexta, 13 de novembro de 2026, um hotel do parque Phantasialand, em Brühl, na Alemanha, teve 15 hóspedes com irritação nas vias respiratórias depois de usar a piscina. O sistema automático de dosagem pôs cloro demais na água. O sistema de segurança da sauna percebeu e deu o alarme, mas só mandou o alarme por e-mail. Naquele dia, o Outlook e boa parte do Microsoft 365 estavam fora do ar, e o e-mail não chegou a ninguém.
O caso é um bom exemplo de um erro comum em monitoramento: o alarme funcionou, mas a única forma de avisar alguém tinha caído. Se o seu alerta de disco cheio, de certificado vencendo ou de fila travada sai só por e-mail, a pergunta é a mesma: o que acontece no dia em que o e-mail cair?
Abaixo estão os fatos do incidente, a configuração que eu montei no Alertmanager para o alerta crítico sair por dois caminhos e o heartbeat que avisa quando o próprio sistema de alertas parou. Tudo rodou de verdade no box, com a saída de cada passo.
O que aconteceu no hotel, segundo a WDR
A emissora pública WDR publicou a reconstrução em 14/11, com informações da polícia e dos bombeiros do distrito de Rhein-Erft e do próprio parque (reportagem da WDR):
- O Phantasialand contou à WDR que, durante a pane da Microsoft, os e-mails não chegavam. Por isso ninguém viu que o sistema de segurança da sauna já tinha dado o alarme por e-mail.
- O dosador automático tinha um defeito e pôs cloro demais na piscina do Hotel Ling Bao, que fica dentro do parque.
- Primeiro 13 hóspedes reclamaram de irritação nas vias respiratórias, e o total chegou a 15. Quatro foram levados ao hospital (no começo falou-se em cinco), e um ficou em observação com uma lesão moderada.
- A água foi trocada e a piscina foi liberada de novo, segundo os bombeiros.
O alarme existia, o sensor mediu certo e o sistema de segurança disparou na hora. O que faltou foi um segundo jeito de avisar.
A queda que levou o e-mail junto
A pane do Microsoft 365 começou na quinta, 12/11, e afetou o Exchange Online e tudo o que depende dele. Segundo o resumo da Reuters publicado pelo Economic Times, as caixas de correio não abriam no Outlook web e desktop, e a entrega de e-mail atrasava. Funções do Teams que não dependem do Exchange continuaram de pé. A Microsoft disse que a causa foi interna, e não um ataque: segundo o iTnews, o problema veio de uma falha numa ampliação de capacidade de rede, que apareceu depois de uma mudança recente na rede. O relatório final com a causa raiz foi prometido para depois da normalização. Quem administra um tenant acompanha os avisos pelo status oficial e pelo centro de administração.
Para quem cuida de alertas, o detalhe importante é este: o e-mail não deu erro para quem enviou. A mensagem saiu do sistema e ficou parada ou atrasada do lado do provedor. Do ponto de vista do equipamento, o alarme foi enviado. É o pior tipo de falha, porque não gera nenhum sinal.
Três perguntas sobre os seus alertas
Antes de mexer em configuração, vale responder isto sobre cada alerta que pode acordar alguém:
- Por quantos caminhos ele sai? Se a resposta é "só e-mail" ou "só um canal do Slack", ele tem um ponto único de falha que você não controla.
- Os caminhos dependem da mesma coisa? E-mail corporativo e Teams caíram juntos no dia 13, porque os dois dependem do Microsoft 365. Dois canais do mesmo provedor contam como um só.
- Quem percebe se o próprio sistema de alertas parar? Se o Alertmanager travar, ou se o servidor que manda o e-mail perder a rede, o resultado é silêncio. E silêncio parece a mesma coisa que "está tudo bem".
O capítulo de monitoramento do livro de SRE do Google separa o que deve chamar uma pessoa na hora (página) do que pode virar chamado ou ficar num painel. A separação ajuda aqui: só o que é página precisa de dois caminhos independentes. O resto pode continuar no e-mail.
O laboratório: Alertmanager 0.35.0 com o "e-mail" fora do ar
Para ver o comportamento real, e não o da documentação, montei um teste pequeno no box (Linux 6.12, Python 3.13.5) com o Alertmanager 0.35.0, a versão mais recente, publicada em 09/11/2026:
- um receptor de e-mail apontando para um servidor SMTP em 127.0.0.1:2525, onde nada escuta. Esse é o "Outlook fora do ar";
- um receptor webhook para o plantão (no mundo real, o app de plantão, um SMS ou uma notificação push);
- um receptor de heartbeat, que recebe o alerta Watchdog;
- um script em Python que recebe os dois webhooks e dispara o alarme se o heartbeat ficar mais de 30 segundos sem chegar.
A configuração inteira é esta. Os tempos estão curtíssimos de propósito, para o teste caber em um minuto:
global:
  resolve_timeout: 5m
  smtp_smarthost: '127.0.0.1:2525'   # o "Outlook": ninguém escuta nessa porta durante o teste
  smtp_from: 'alertas@empresa.test'
  smtp_require_tls: false

route:
  receiver: email-equipe
  group_by: ['alertname']
  group_wait: 1s
  group_interval: 5s
  repeat_interval: 4h
  routes:
    # o alerta que tem de chegar sempre: sai por dois caminhos independentes
    - matchers: ['severity="critical"']
      receiver: email-equipe
      continue: true
    - matchers: ['severity="critical"']
      receiver: plantao-webhook
    # o "alerta que avisa que os alertas estão vivos"
    - matchers: ['alertname="Watchdog"']
      receiver: heartbeat
      group_wait: 0s
      group_interval: 5s
      repeat_interval: 10s

receivers:
  - name: email-equipe
    email_configs:
      - to: 'manutencao@empresa.test'
        send_resolved: true
  - name: plantao-webhook
    webhook_configs:
      - url: 'http://127.0.0.1:9101/plantao'
  - name: heartbeat
    webhook_configs:
      - url: 'http://127.0.0.1:9102/ping'
O detalhe que faz o alerta sair duas vezes é o continue: true. Sem ele, o Alertmanager para na primeira rota que casa, e o alerta crítico iria só para o e-mail. A documentação de configuração explica a árvore de rotas e o continue. Outra opção é pôr email_configs e webhook_configs dentro do mesmo receptor, mas rotas separadas deixam mais claro quem recebe o quê.
Conferir as rotas antes de subir
O amtool, que vem no mesmo pacote, valida o arquivo e diz para onde cada combinação de rótulos vai. É o teste mais barato que existe e cabe em qualquer pipeline:
$ amtool check-config alertmanager.yml
Checking 'alertmanager.yml'  SUCCESS
Found:
 - global config
 - route
 - 0 inhibit rules
 - 3 receivers
 - 0 templates

$ amtool config routes test --config.file=alertmanager.yml alertname=CloroAlto severity=critical
email-equipe,plantao-webhook
$ amtool config routes test --config.file=alertmanager.yml alertname=DiscoQuaseCheio severity=warning
email-equipe
$ amtool config routes test --config.file=alertmanager.yml alertname=Watchdog severity=none
heartbeat
O crítico vai para os dois, o aviso comum fica só no e-mail e o Watchdog vai só para o heartbeat. Se alguém apagar o continue: true num pull request, a primeira linha passa a mostrar só email-equipe e o teste pega.
Disparar o alerta com o SMTP fora
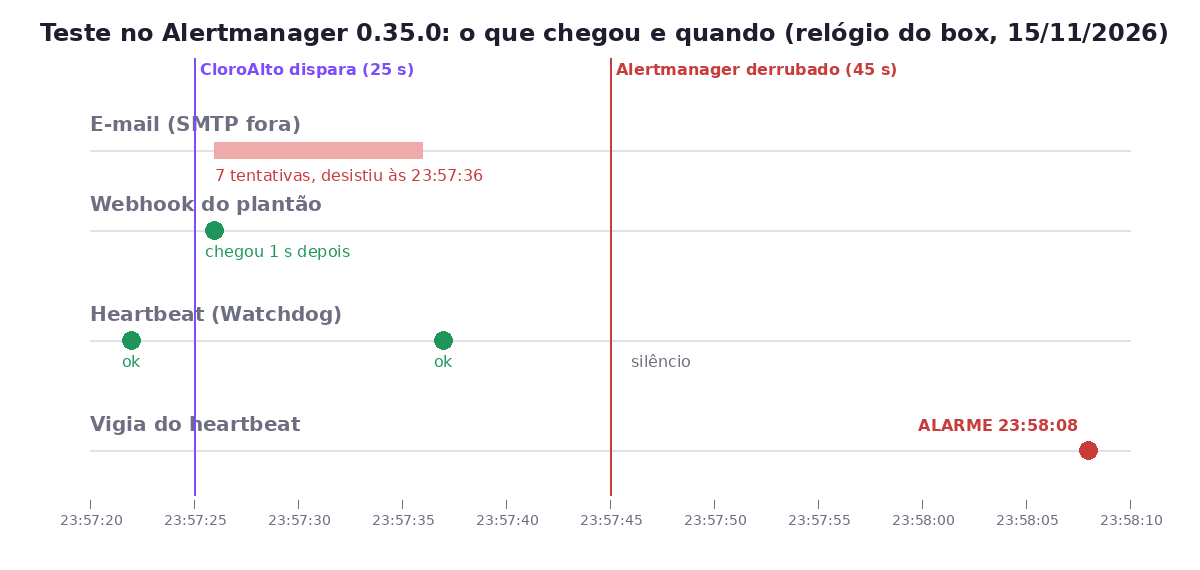
Com o Alertmanager no ar, um laço mandava o Watchdog a cada 5 segundos com amtool alert add, fazendo o papel do Prometheus. Às 23:57:25 (horário de Brasília) disparei o alerta crítico:
$ amtool alert add alertname=CloroAlto severity=critical local=piscina \
    --alertmanager.url=http://127.0.0.1:9093
O webhook do plantão recebeu o alerta às 23:57:26, um segundo depois. O e-mail tentou, falhou e foi tentando de novo. O log do Alertmanager mostra a desistência dessa rodada às 23:57:36:
level=WARN msg="Notify attempt failed, will retry later" receiver=email-equipe
  integration=email[0] attempts=1 reason=other
  err="establish connection to server: dial tcp 127.0.0.1:2525: connect: connection refused"
level=ERROR msg="Notify failed" receiver=email-equipe integration=email[0] reason=other
  err="email-equipe/email[0]: notify retry canceled after 7 attempts: establish connection
  to server: dial tcp 127.0.0.1:2525: connect: connection refused"
E as métricas que o próprio Alertmanager expõe em /metrics registraram a falha. Filtrei só as linhas com valor diferente de zero:
alertmanager_notifications_failed_total{integration="email",reason="other"} 1
alertmanager_notifications_total{integration="email"} 2
alertmanager_notifications_total{integration="webhook"} 3
Duas coisas ficam claras. A falha de um caminho não segurou o outro: o webhook não esperou o e-mail desistir. E aqui o SMTP recusou a conexão, então pelo menos houve erro e métrica. No caso real do dia 13, o servidor de e-mail do provedor pode ter aceitado a mensagem e atrasado a entrega. Aí nem essa métrica sobe. Por isso o segundo caminho importa mais do que qualquer contador de falha.
O alerta que avisa que os alertas pararam
Dois caminhos resolvem a queda de um canal, mas não resolvem a queda do próprio Alertmanager, do Prometheus ou da rede do servidor. Para isso existe o padrão "dead man's switch": um alerta que fica disparado o tempo todo, e um sistema de fora que grita quando ele para de chegar.
O kube-prometheus traz esse alerta com o nome Watchdog. O runbook oficial descreve assim: um alerta feito para garantir que toda a cadeia de alertas está funcionando, que fica sempre disparado e sempre entregue a um receptor. Se ele não estiver disparando, um sistema externo precisa avisar que o sistema de alertas parou. No Prometheus, a regra costuma ser só isto:
groups:
  - name: meta
    rules:
      - alert: Watchdog
        expr: vector(1)
        labels:
          severity: none
        annotations:
          summary: "Cadeia de alertas viva. Se parar de chegar, algo quebrou."
Nesta rodada não rodei o Prometheus nem o promtool. No teste, quem mandava o Watchdog era o laço com amtool alert add. O efeito no Alertmanager é o mesmo, mas a regra acima eu não testei aqui.
O vigia do teste é um script em Python de umas 40 linhas que recebe os webhooks e confere, a cada 2 segundos, há quanto tempo o último heartbeat chegou. A parte que importa:
LIMITE = 30

def vigia():
    while True:
        time.sleep(2)
        parado = time.time() - ultimo["ping"]
        if parado > LIMITE and not alarmou["v"]:
            alarmou["v"] = True
            print(f"{agora()} ALARME: {int(parado)} s sem heartbeat. O caminho dos alertas caiu.")
Às 23:57:45 derrubei o Alertmanager com kill. A saída completa do teste, em ordem:
23:57:20 receptor no ar (limite do heartbeat: 30 s)
23:57:22 heartbeat ok (firing)
23:57:25 disparo CloroAlto (critical)
23:57:26 PLANTAO recebeu firing: ['CloroAlto']
23:57:37 heartbeat ok (firing)
23:57:45 derrubo o Alertmanager (kill 1228388)
23:58:08 ALARME: 31 s sem heartbeat. O caminho dos alertas caiu.
O alarme veio 23 segundos depois da queda, e não 30. É que o relógio conta a partir do último heartbeat que chegou (23:57:37), e não do momento da queda. Na prática, o tempo até descobrir fica entre o limite menos o intervalo do heartbeat e o limite inteiro.
Outro detalhe que o teste mostrou: pedi repeat_interval: 10s para o Watchdog, mas os heartbeats chegaram com cerca de 15 segundos de distância (23:57:22 e 23:57:37). O Alertmanager só reenvia nas rodadas do group_interval, então o intervalo real fica "arredondado" para cima. Em produção, com repeat_interval de 1 minuto e group_interval de 5 minutos, isso faz diferença: o limite do vigia precisa ficar acima do intervalo real, ou ele vai dar alarme falso. Meça o intervalo no seu ambiente antes de escolher o limite.
No gráfico abaixo está o mesmo teste numa linha do tempo, com os horários do box.
O vigia não pode morar no mesmo lugar
O script do teste rodou na mesma máquina do Alertmanager, e serve só para mostrar o mecanismo. Em produção, o vigia tem de ficar fora de tudo o que ele vigia: outra rede, outro provedor e, de preferência, outro jeito de avisar. As opções mais comuns:
- Serviço de heartbeat externo: o Healthchecks.io (que tem versão open source para hospedar em outro lugar) recebe pings numa URL e avisa quando eles param, por vários canais. O mesmo serve para cron jobs e backups noturnos.
- Integração de dead man's switch do app de plantão: o runbook do Watchdog cita a integração DeadMansSnitch do PagerDuty como exemplo.
- Um segundo monitor, pequeno, em outra nuvem, que só confere o heartbeat e manda SMS. Ele precisa ser simples, para não virar mais uma coisa a vigiar.
Vale também alertar sobre as falhas de envio, usando a métrica que apareceu no teste. O kube-prometheus tem o alerta AlertmanagerFailedToSendAlerts, feito para isso (runbook). A expressão do kube-prometheus é esta (não rodei esta regra no teste; a métrica, sim):
rate(alertmanager_notifications_failed_total[5m])
  / ignoring(reason) group_left
rate(alertmanager_notifications_total[5m]) > 0.01
Esse alerta precisa sair pelo caminho que não falhou. Se ele sair só pelo e-mail que caiu, você volta ao problema do hotel.
Testar o caminho, não só o alarme
A maioria das equipes testa se a regra dispara. Poucas testam se a mensagem chega a uma pessoa. Algumas práticas que ajudam:
- Rodar o
amtool config routes testno CI para cada alerta crítico. Assim, uma rota que perdeu o segundo caminho quebra o build. - Fazer um ensaio de queda do canal: bloquear de propósito a saída SMTP num ambiente de teste, como eu fiz com a porta 2525, e ver se o alerta crítico chega pelo outro caminho. É a mesma lógica do teste de restore: backup que ninguém restaurou não é backup, e alerta que nunca foi recebido num ensaio não é alerta.
- Revisar os alertas que ninguém atende. Ter dois caminhos não adianta se o alerta é barulhento e as pessoas já o ignoram. O post sobre alertas no Prometheus por SLO trata disso, com testes de regra no
promtool. - Escrever o pós-incidente quando um alerta não chegar, mesmo que não tenha dado em nada. O formato sem culpado ajuda a achar a causa no sistema, como "o único canal era o e-mail", e não numa pessoa.
Se o seu e-mail de alerta sai de um domínio próprio, vale conferir também a autenticação. Sem SPF, DKIM e DMARC certos, o Outlook pode recusar a mensagem, e o alerta some sem nenhuma queda (veja como configurar o DMARC). É mais um motivo para o e-mail não ser o único caminho.
O que levar daqui
- Alerta que precisa acordar alguém sai por pelo menos dois caminhos que não dependem do mesmo provedor. No Alertmanager, isso é uma rota com
continue: trueou um receptor com duas integrações. - Um alerta sempre disparado (Watchdog) e um vigia externo transformam o silêncio em sinal.
- Meça o intervalo real do heartbeat antes de escolher o limite do vigia. No teste, 10 segundos pedidos viraram cerca de 15.
- Teste o caminho até a pessoa, e não só a regra. O
amtoolfaz isso em milissegundos.
No hotel, o sensor estava certo, o alarme disparou e o e-mail saiu. Só não havia ninguém do outro lado. Quase sempre, a peça que falta é um segundo caminho barato, e não um sensor melhor.